


Doubao Seedream 5.5(以下简称 Seedream 5.5)支持文生图、单图生图和多参考图生图,并进一步增强多轮编辑一致性、原生 RGBA 图片生成和图层拆分能力。图层拆分时,模型最多可输出 1 张底图和 99 个图层,并可为规整文字图层返回文字内容、位置和近似视觉样式等富文本 OCR 信息。
本文重点介绍 Seedream 5.5 的特色能力。图片生成 API 的完整字段定义、取值范围和返回结构,请参见 Image generation API。
特色能力#
Seedream 5.5 的特色能力如下。
| 特色能力 | 能力介绍 | 效果预览 |
|---|---|---|
| 多轮编辑一致性 |
|
|
| 原生 RGBA 图片 |
|
|
| 更精细的图层拆分 及 富文本 OCR |
|
能力概述#
Seedream 5.5 在 Seedream 5.0 pro / flash 的图片生成和图层拆分能力基础上,重点增强多轮编辑一致性,并扩展 RGBA 图片生成的场景和输入范围,支持更精细的图层拆分和富文本 OCR。三款模型的主要能力区别如下:
| 模型名称 | Seedream 5.5 | Seedream 5.0 pro | Seedream 5.0 flash | |
|---|---|---|---|---|
| Model ID | doubao-seedream-5-5-261028 | doubao-seedream-5-0-pro-260628 | doubao-seedream-5-0-flash-260915 | |
| 文生图 | ✓ | ✓ | ✓ | |
| 单图生图 | ✓ | ✓ | ✓ | |
| 多参考图生图 | ✓,最多输入 10 张参考图 | ✓,最多输入 10 张参考图 | ✓,最多输入 10 张参考图 | |
| 图层拆分 | ✓,1 张底图 + 最多 99 个图层 | ✓,1 张底图 + 最多 16 个图层 | ✓,1 张底图 + 最多 16 个图层 | |
| 原生 RGBA 图片 | 文生图 | ✓ | — | — |
| 图生图 | ✓,最多输入 10 张参考图,输入图无需带透明通道 | ✓,仅支持输入 1 张带透明通道的 PNG 参考图 | ✓,仅支持输入 1 张带透明通道的 PNG 参考图 | |
设置最大输出图片数图层拆分 |
✓,支持指定 2–100 张,包含底图和图层 | — | — | |
| 富文本 OCR | ✓ | — | — | |
| 模型参数 | 分辨率图片生成 |
|
|
|
分辨率图层拆分 |
1K、1.5K、2K、auto(默认值) | 1K、1.5K、2K、auto(默认值) | 1K、1.5K、2K、auto(默认值) | |
| 图片文件格式 | png(默认值)、jpeg | png、jpeg(默认值) | png、jpeg(默认值) | |
背景类型图片生成 |
auto(默认值)、transparent、opaque | transparent、opaque(默认值) | transparent、opaque(默认值) | |
| 提示词优化模式 | 标准模式(默认值) | 标准模式(默认值), 极速模式 | 标准模式(默认值) | |
基础使用#
Seedream 5.5 的文生图、单张图生图、多参考图生图和交互编辑调用方式与 Seedream 5.0 pro / flash 一致。调用时,将请求中的 model 设置为 Seedream 5.5 的 Model ID:doubao-seedream-5-5-261028。
通用调用步骤和代码示例请参见:
多轮编辑一致性#
Seedream 5.5 支持对同一图片进行连续编辑,并增强多轮编辑中主体特征、构图和未编辑区域的一致性。每轮编辑时,将上一轮生成结果作为输入,并通过提示词明确本轮需要修改和保持不变的内容。
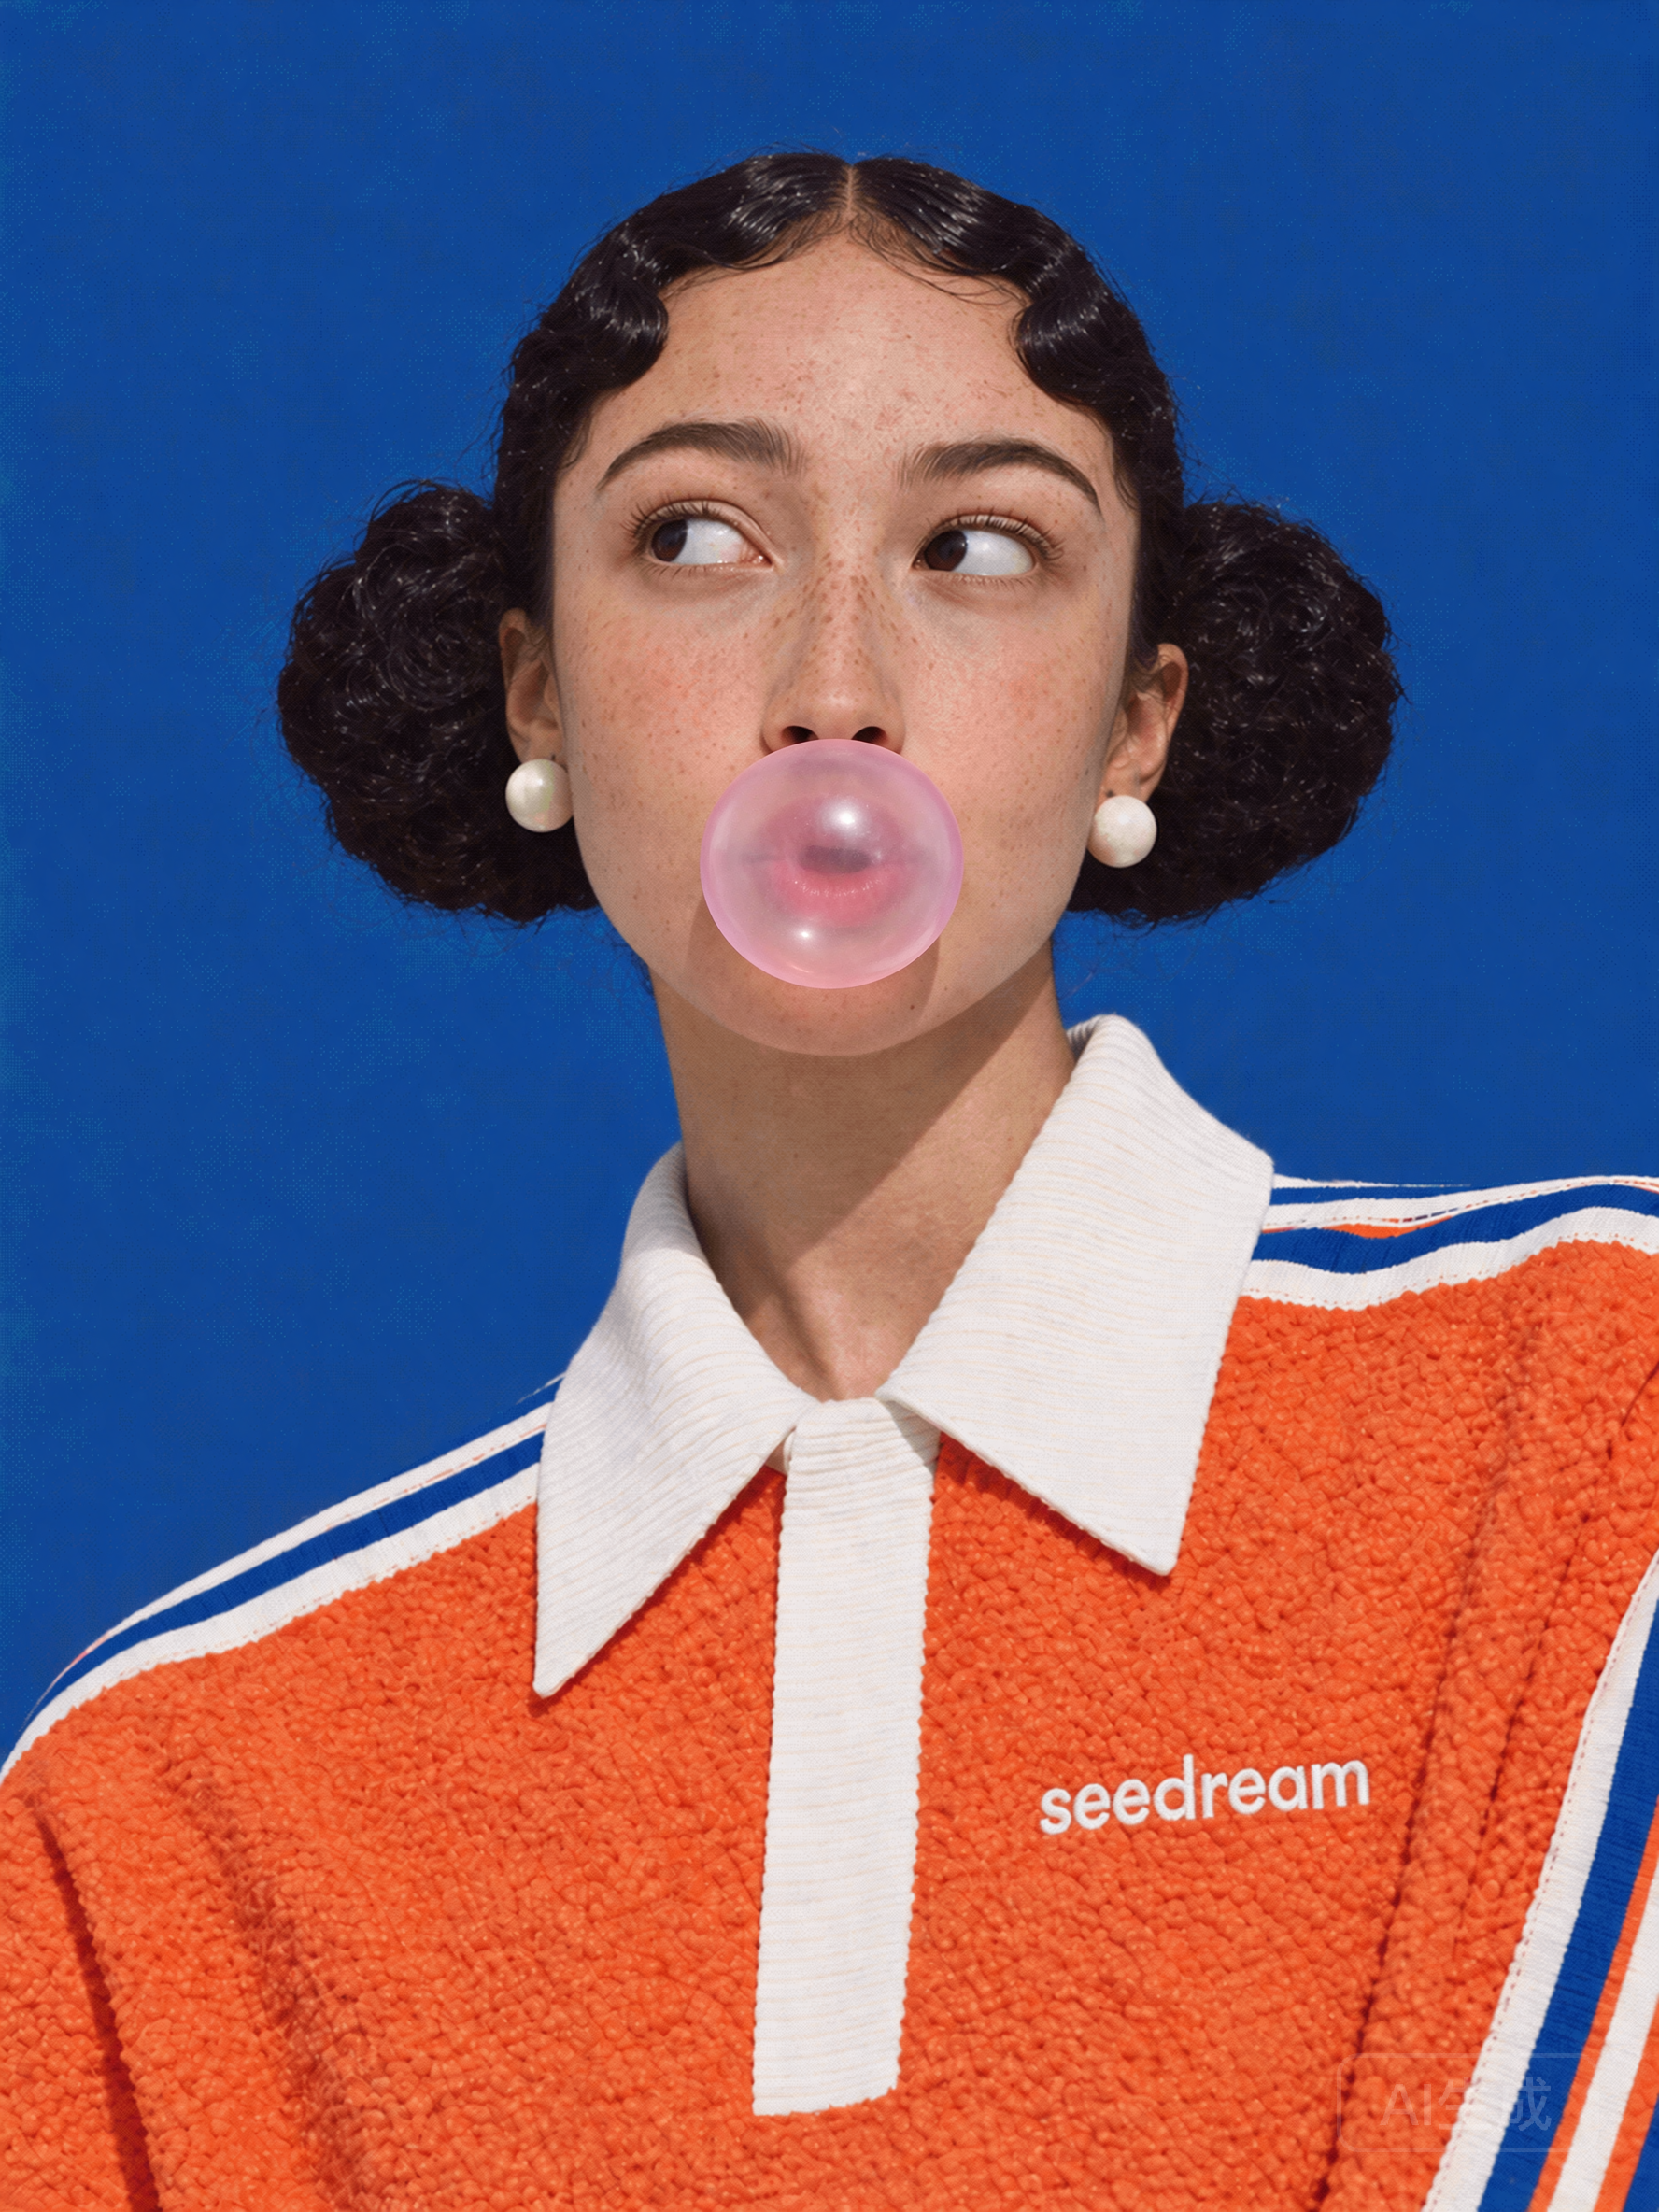
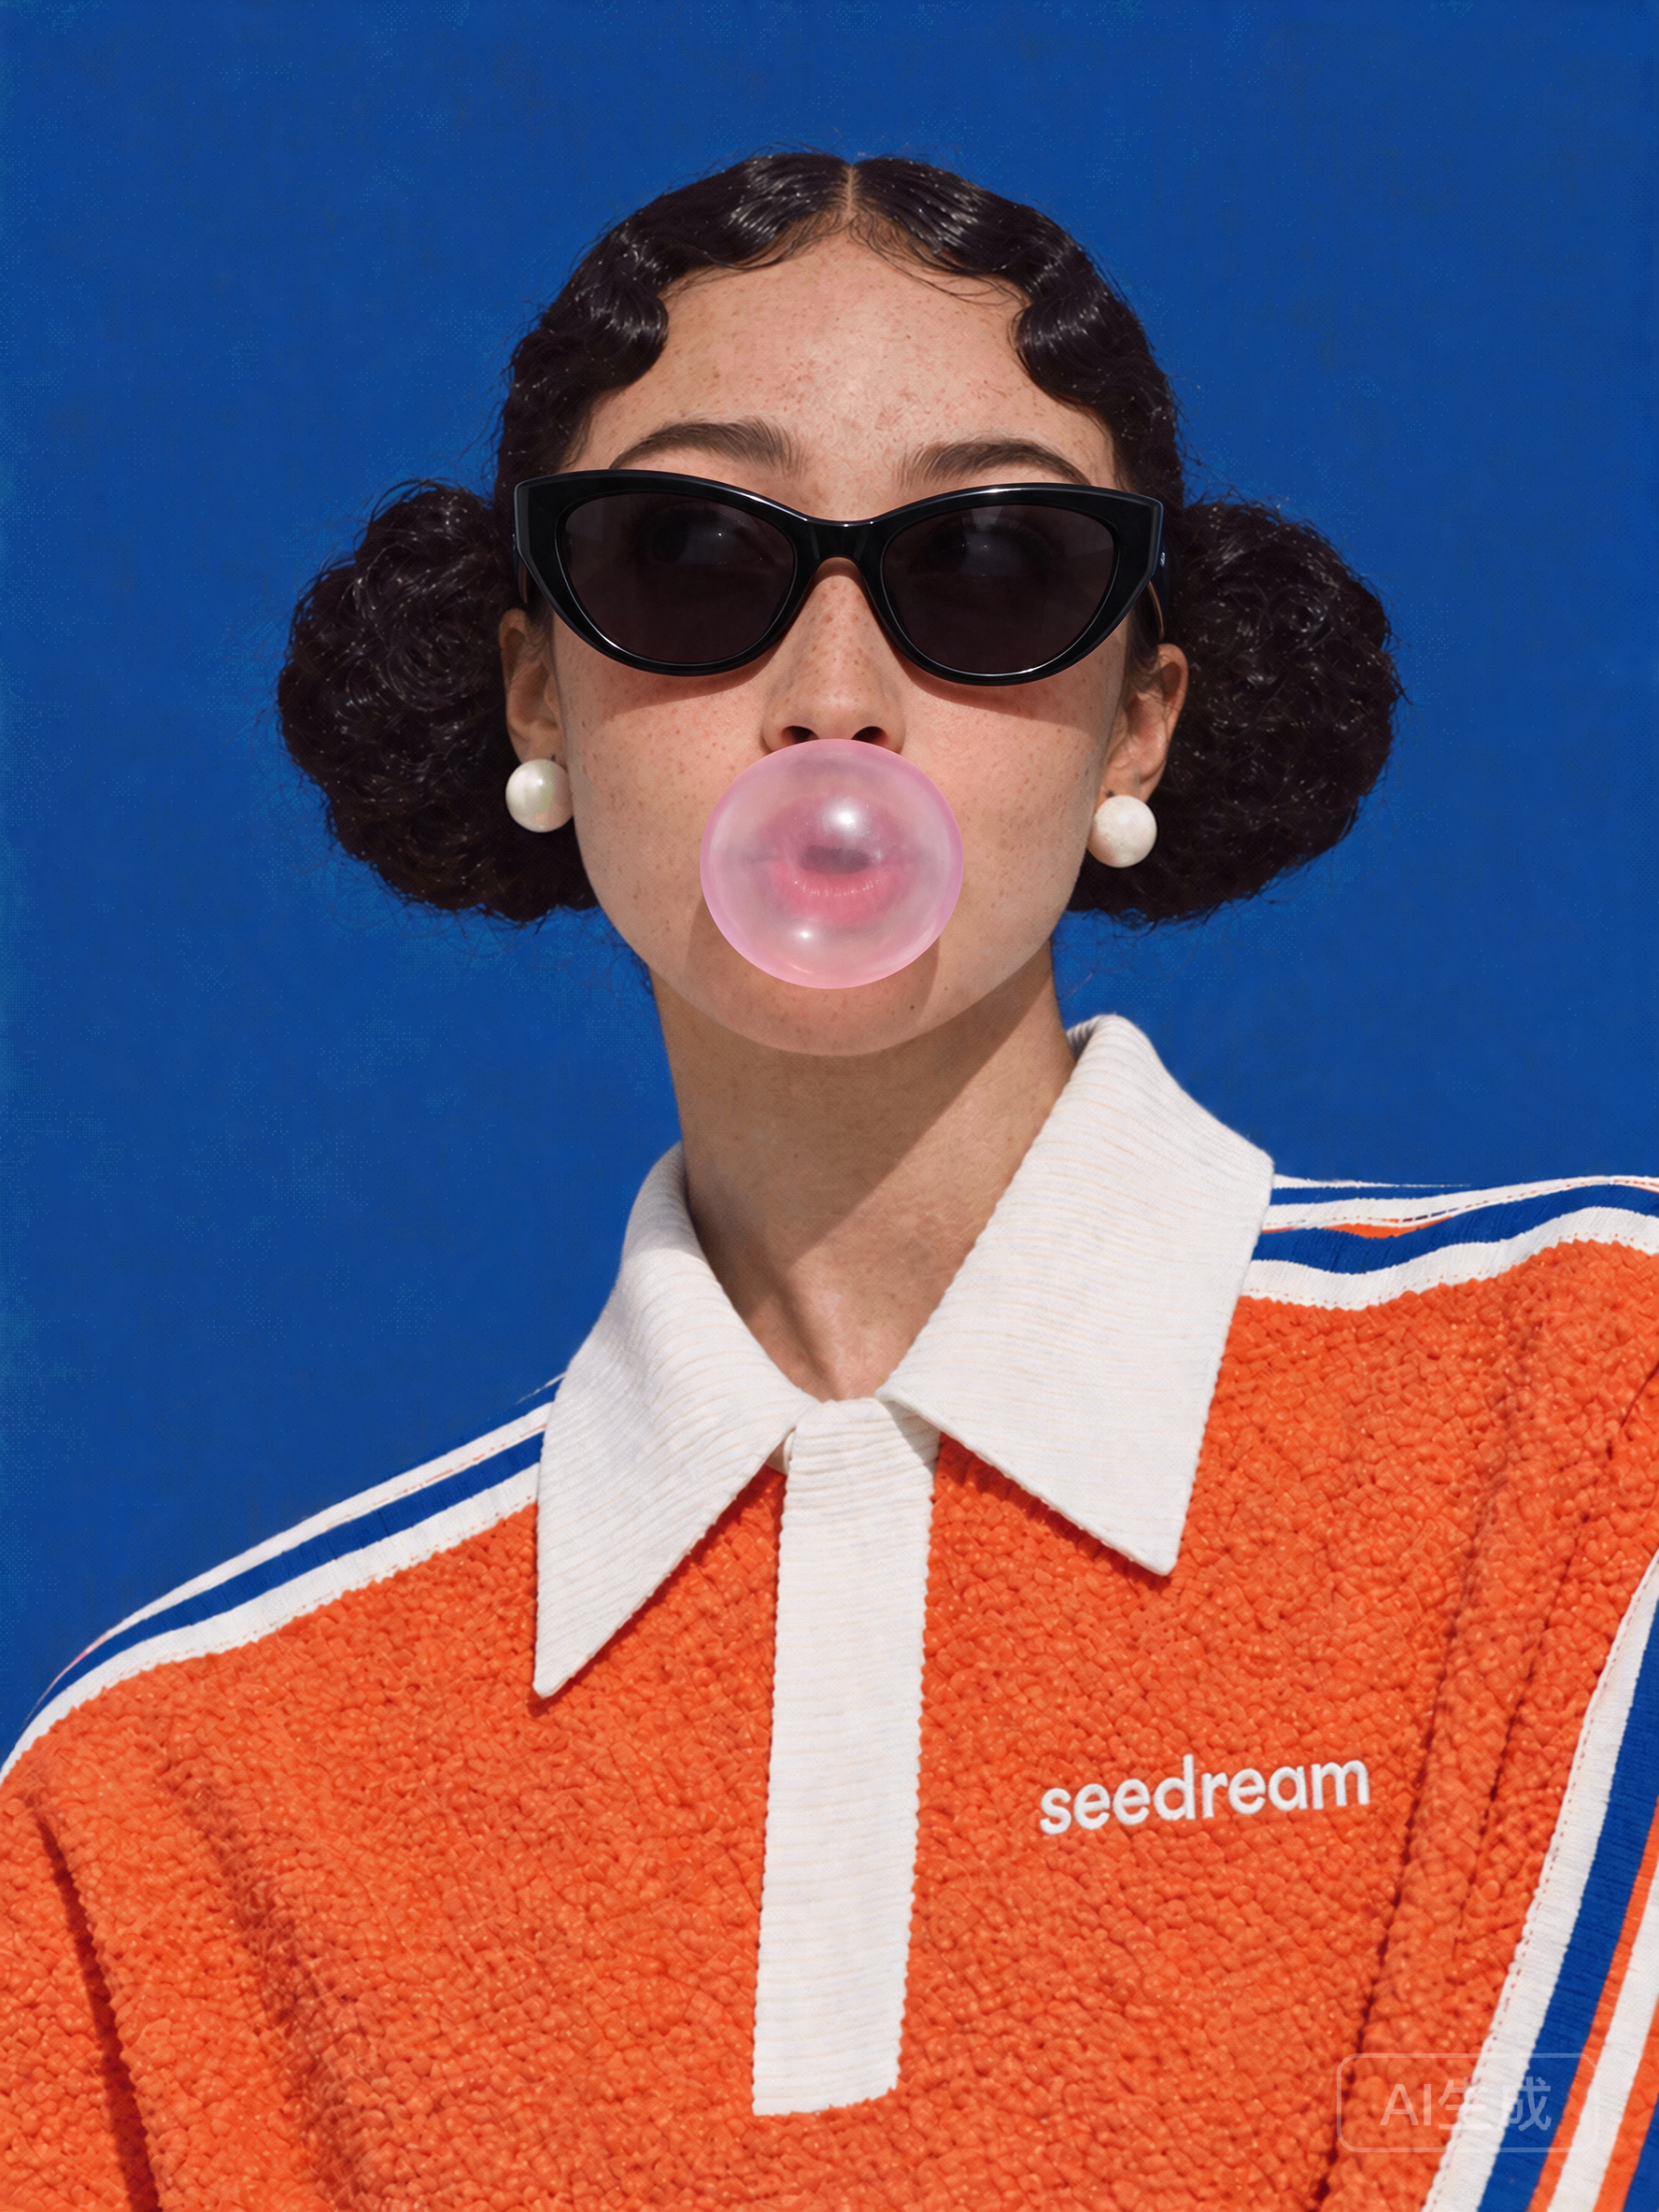
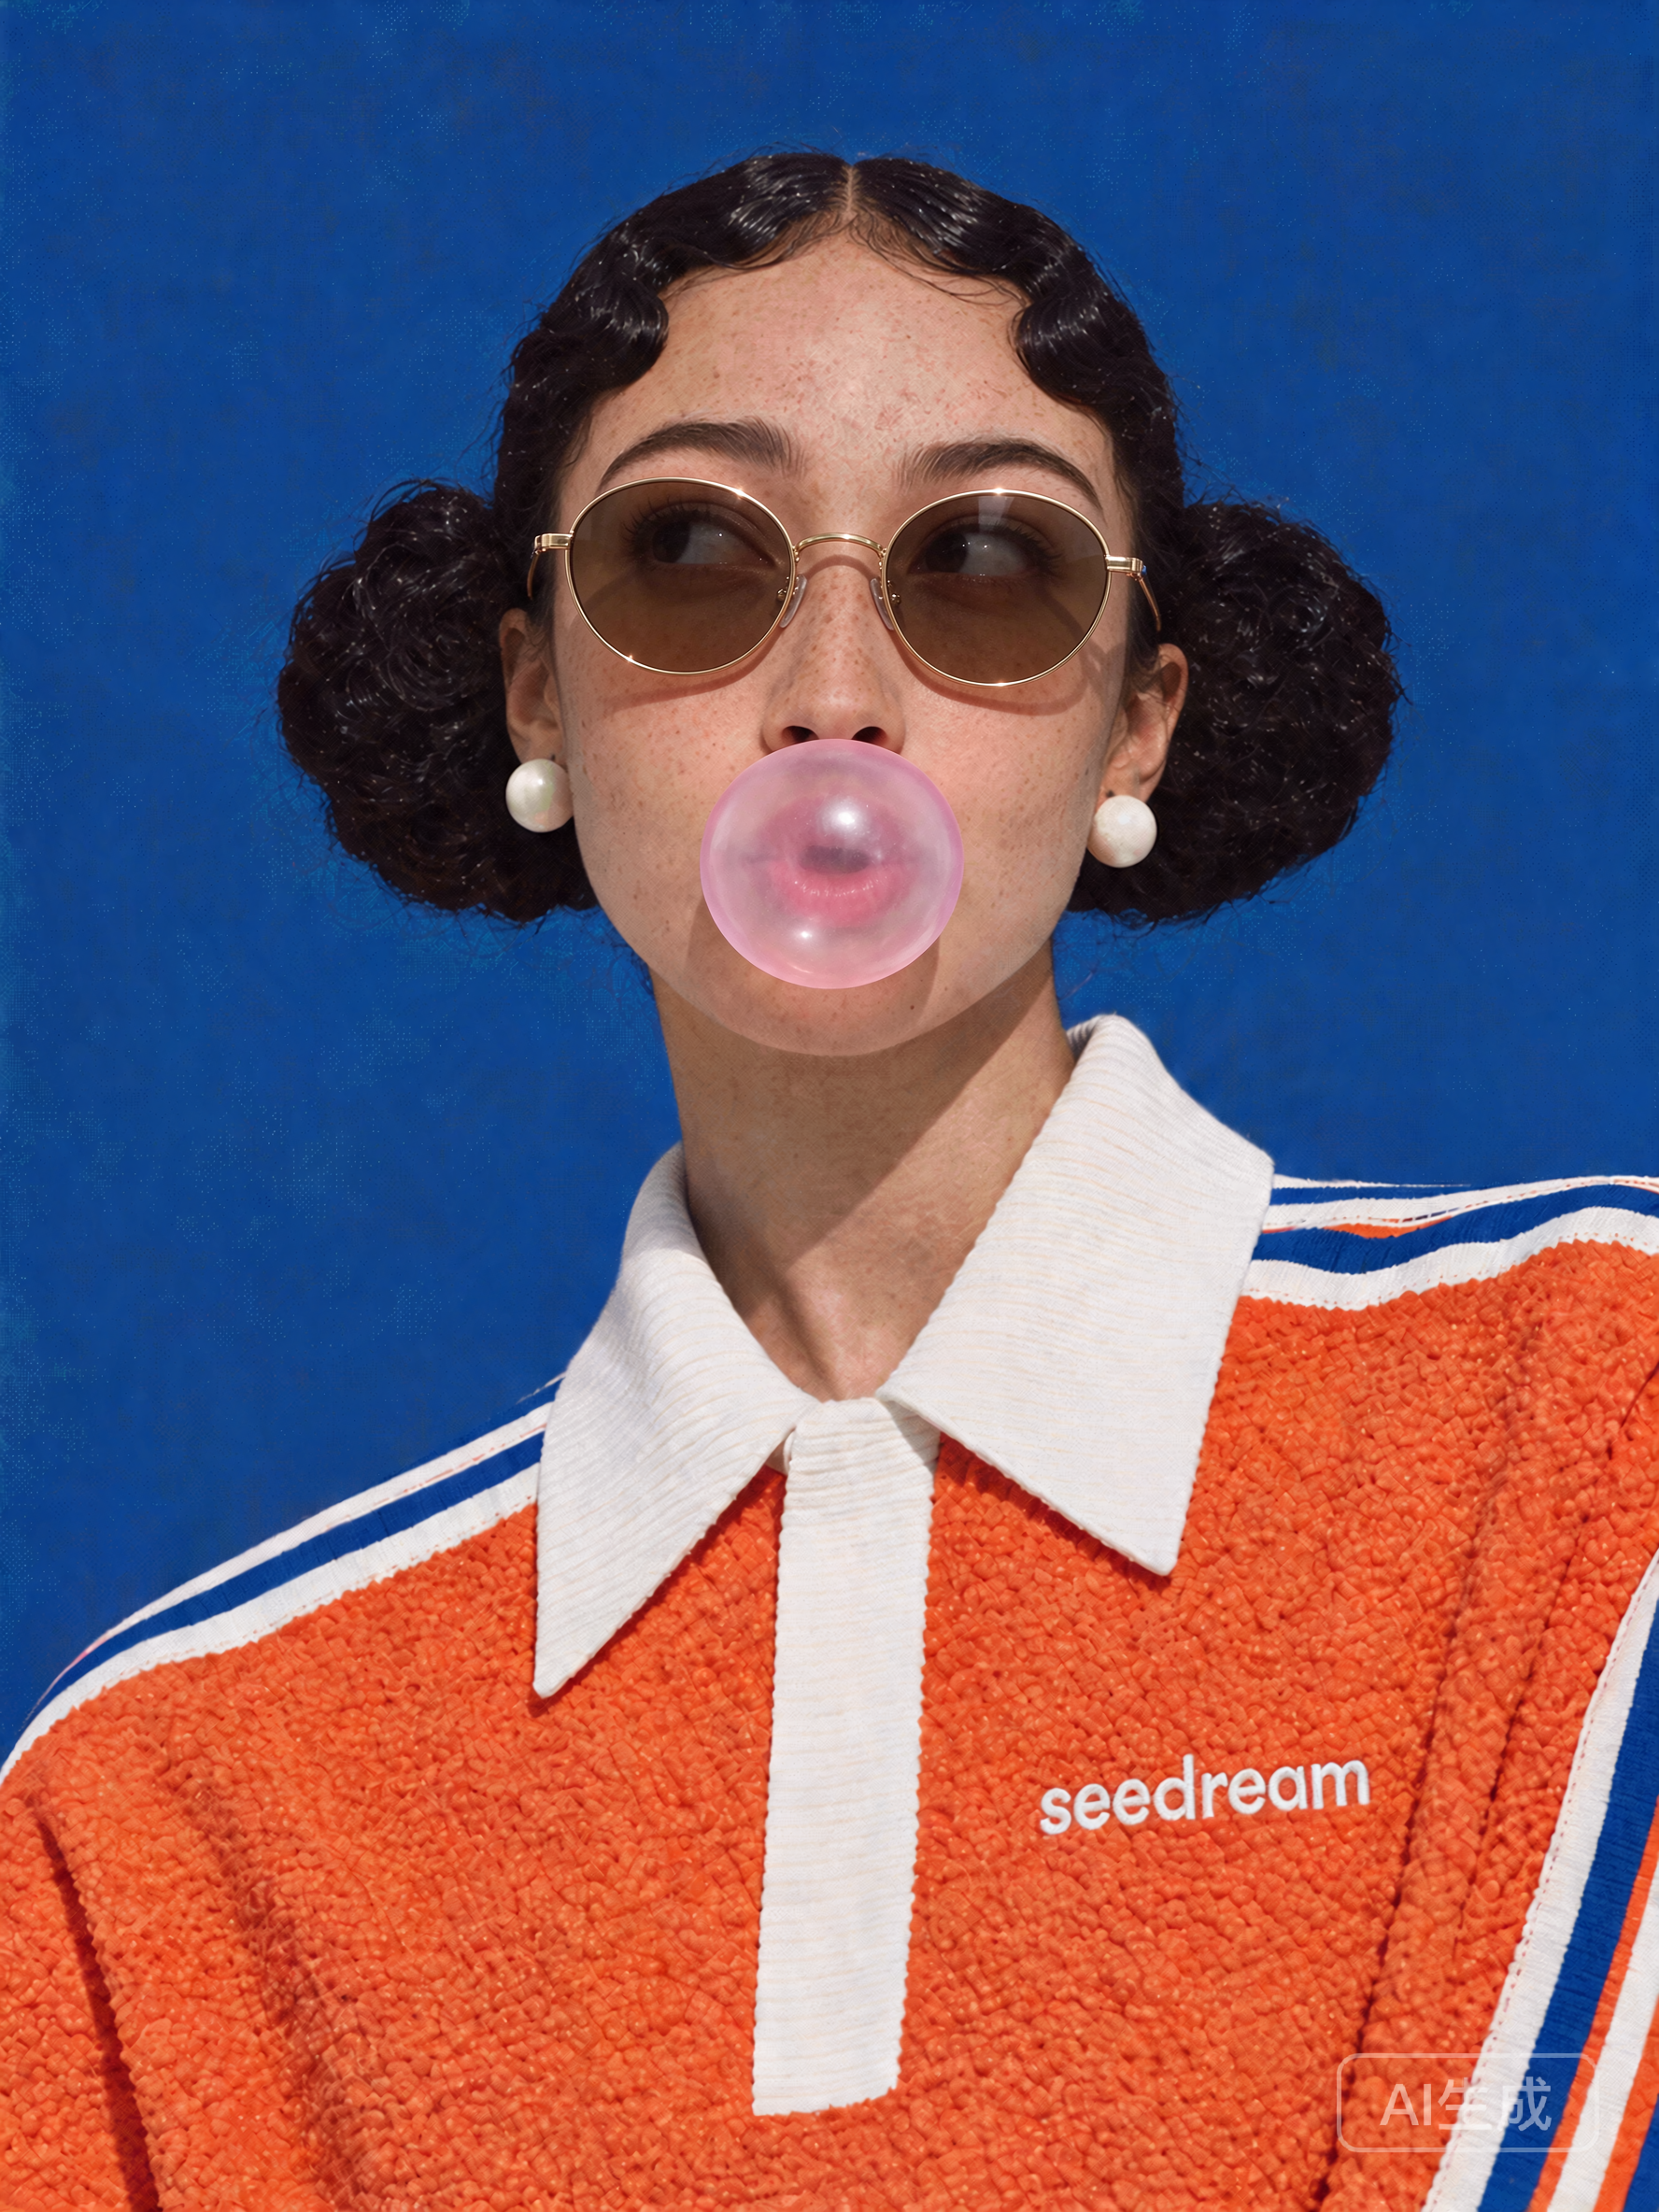
以下示例连续编辑同一张人物图片,每轮以上一轮输出为输入,并保留此前的编辑结果。
代码示例仅展示第一轮请求。后续轮次可将上一轮响应中的图片 URL 作为
image,并替换prompt。
| 原始输入 | 第一轮添加泡泡糖 |
第二轮添加太阳镜 |
第三轮更改太阳镜款式 |
多轮编辑效果 |
|---|---|---|---|---|
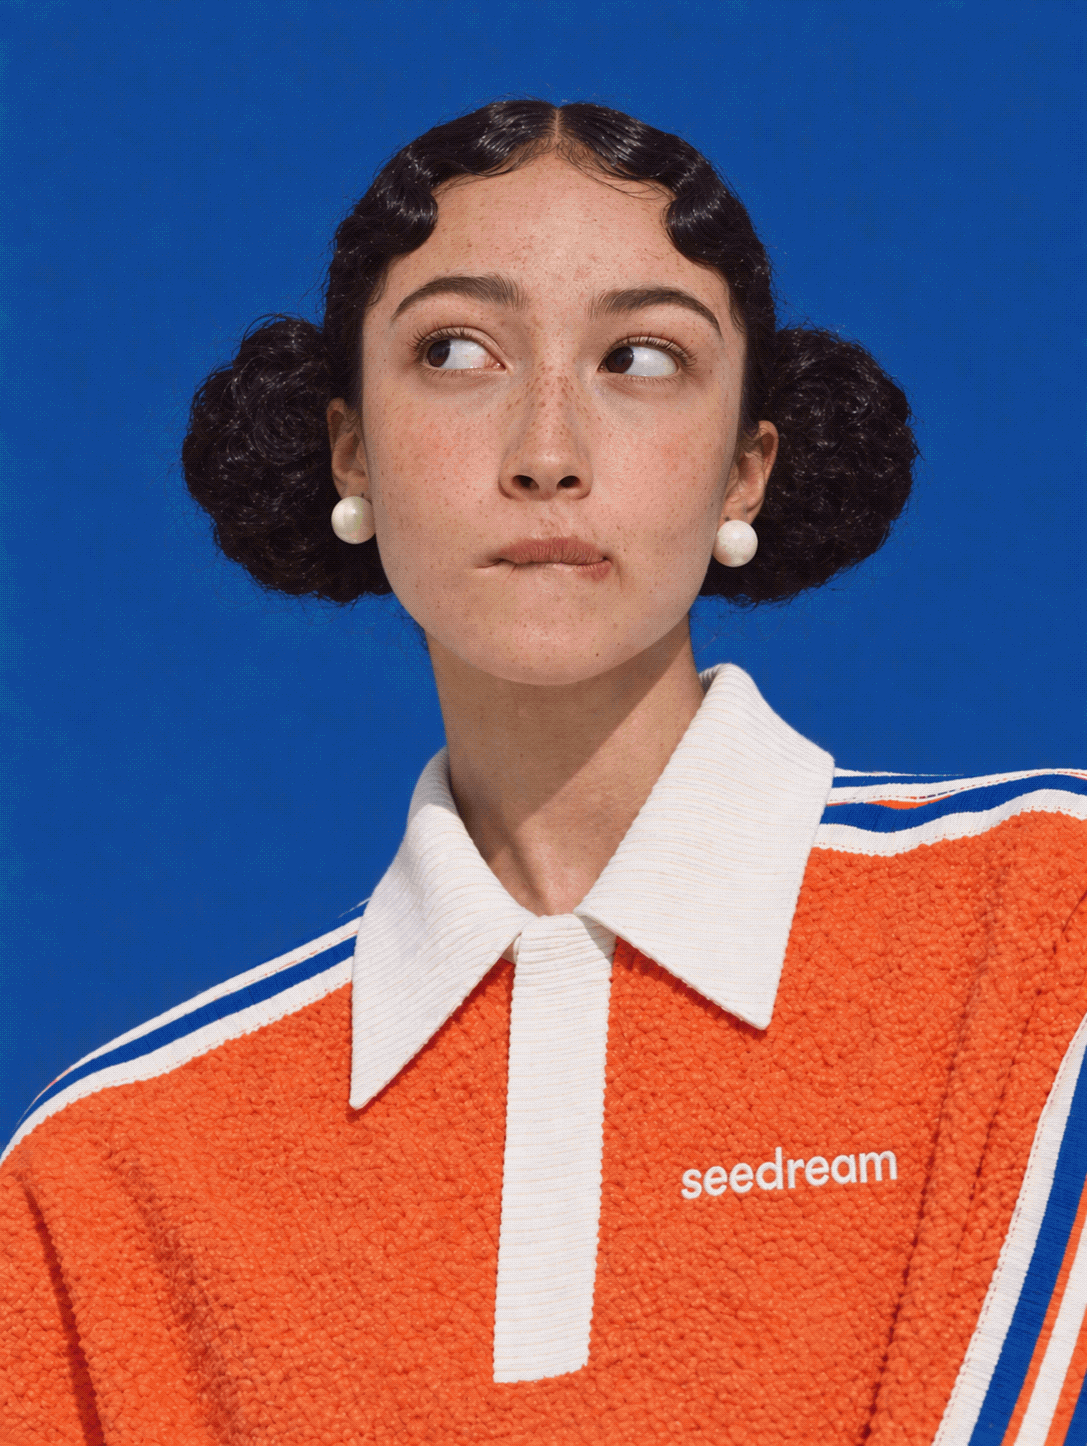 |
 |
 |
 |
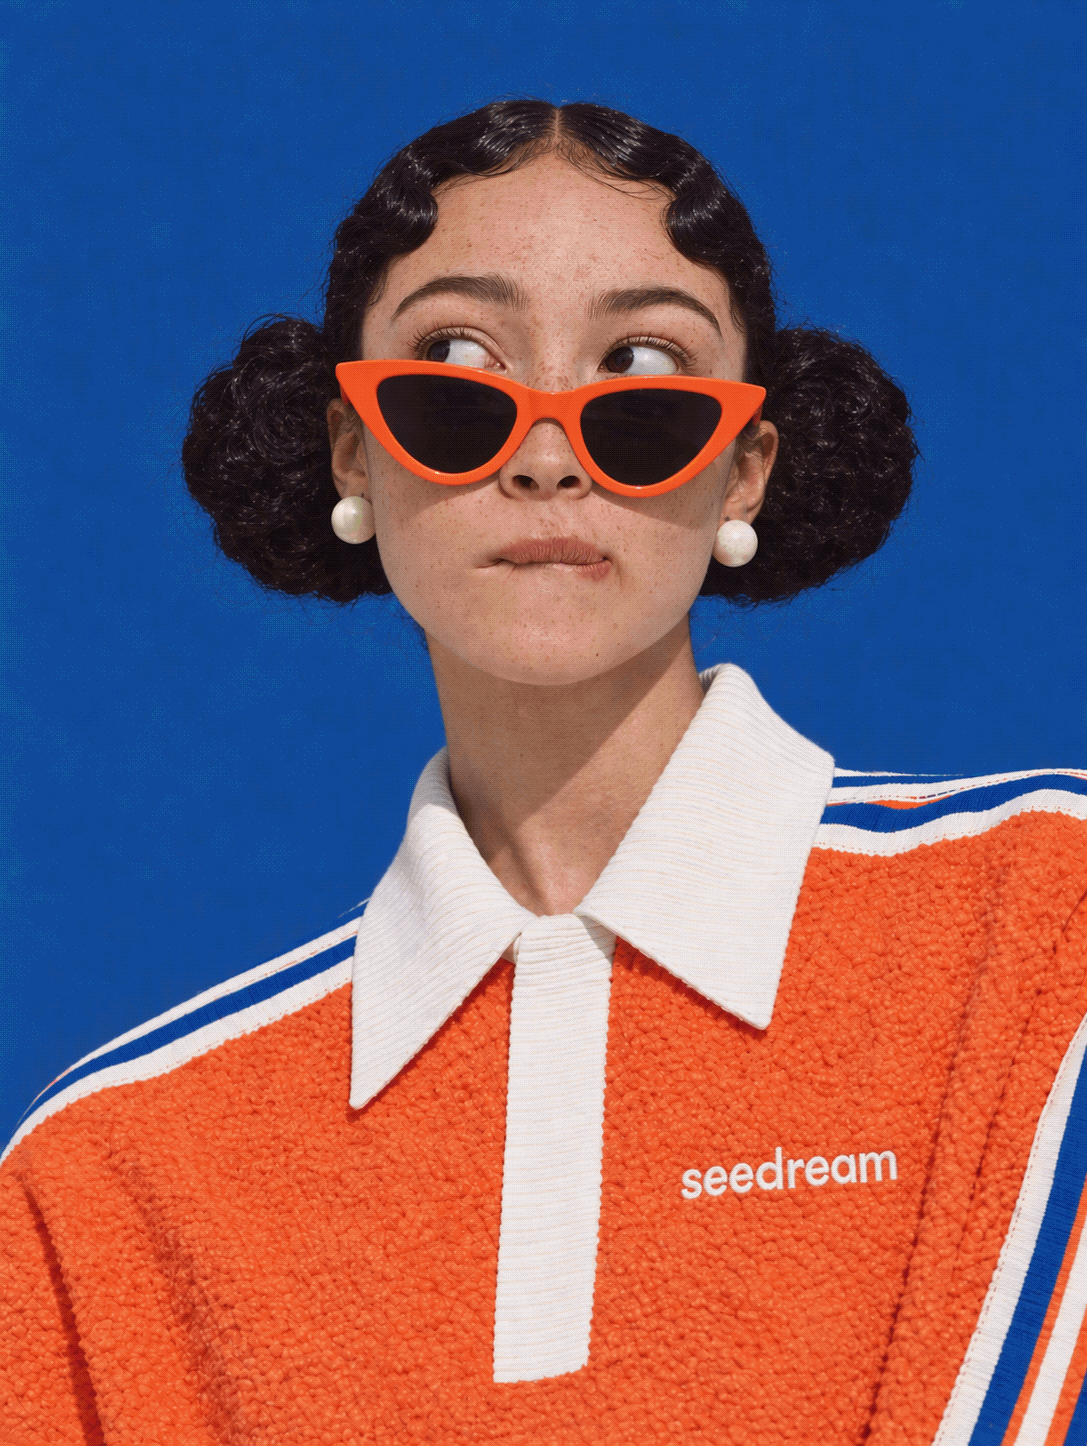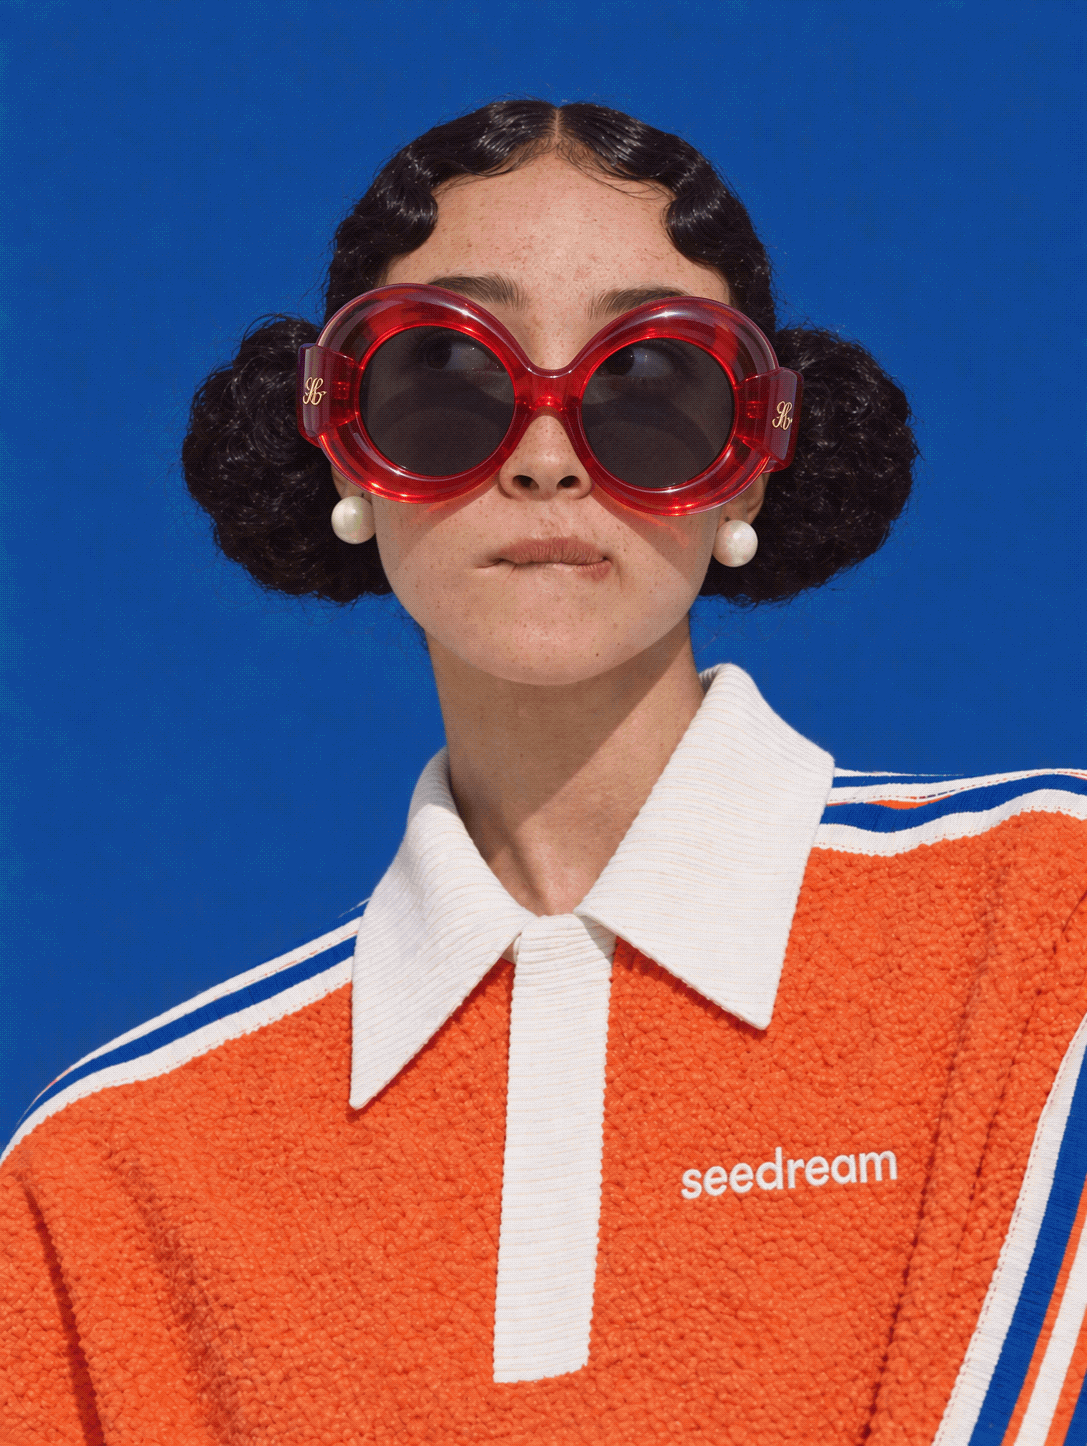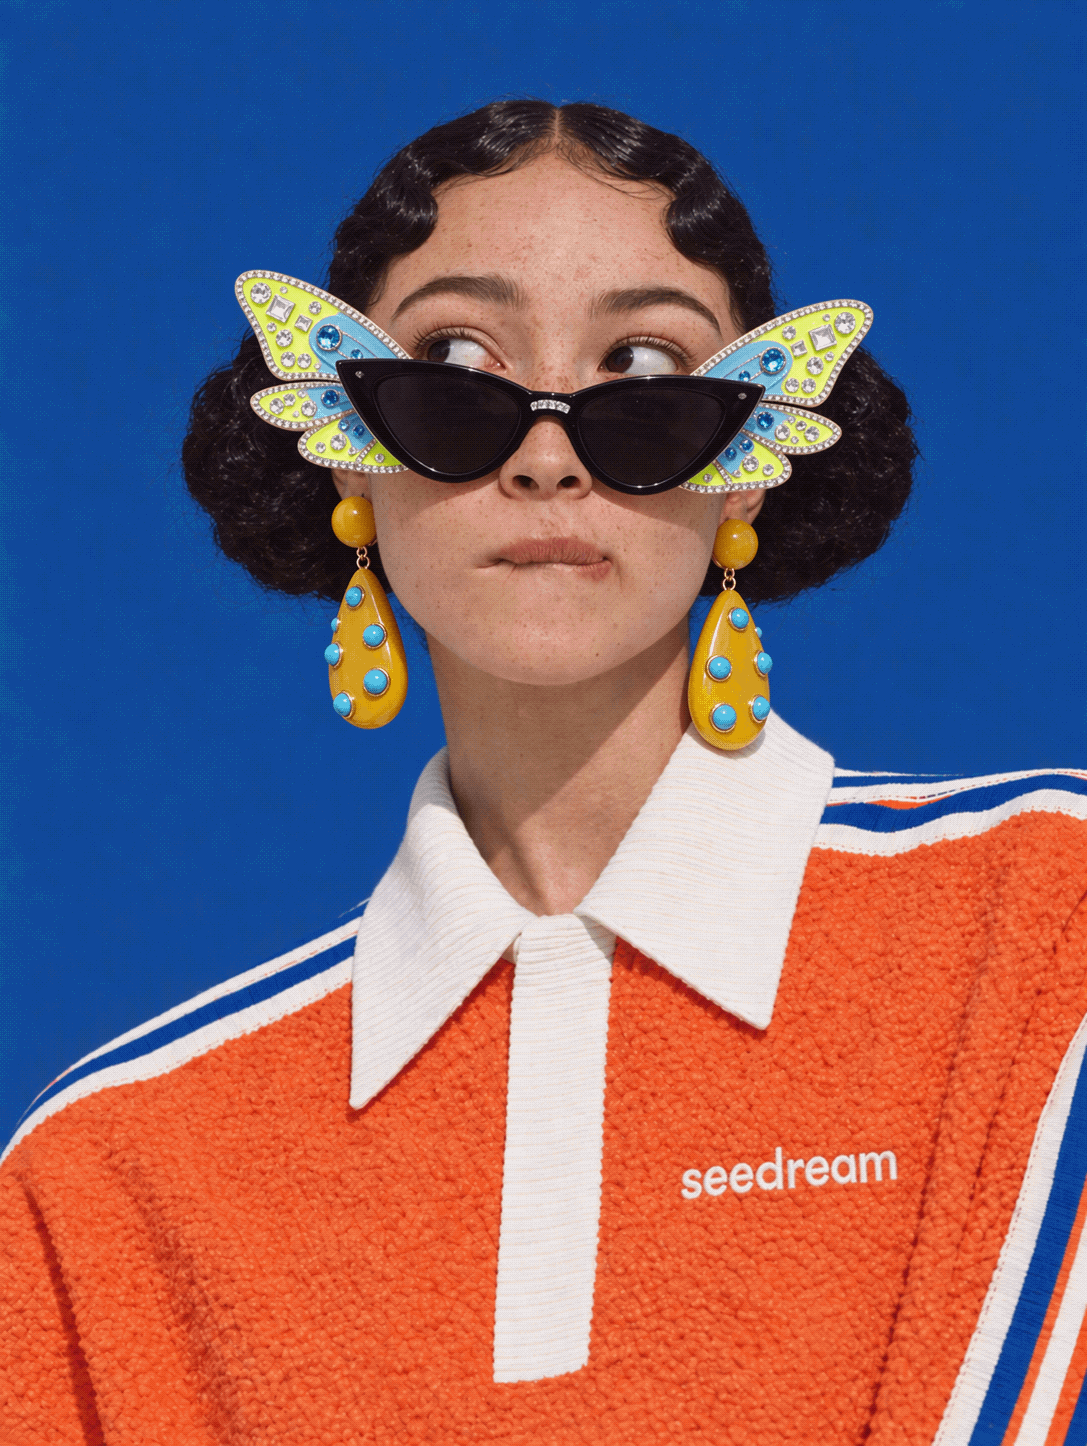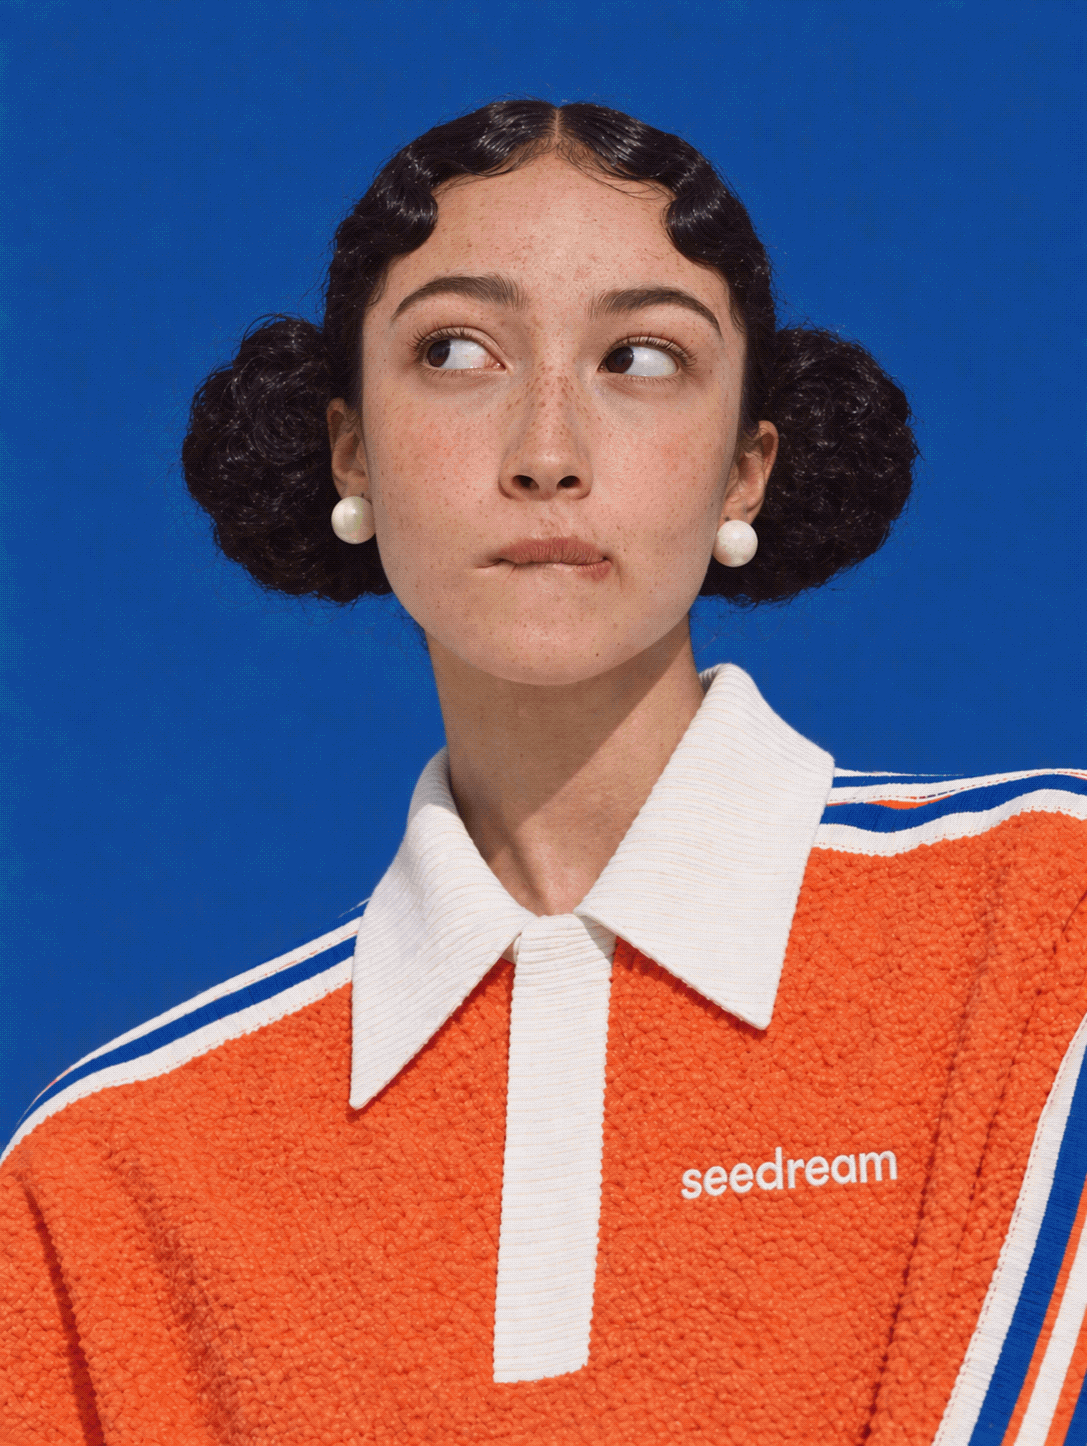 |
curl https://ark.cn-beijing.volces.com/api/v3/images/generations \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $ARK_API_KEY" \
-d '{
"model": "doubao-seedream-5-5-261028",
"prompt": "让人物用嘴吹出一个圆润、半透明的粉色泡泡糖泡泡。保持人物身份、面部特征、视线、发型、珍珠耳饰、服装、姿态、蓝色背景、构图和画面风格不变。",
"image": "https://arkdocs.tos-cn-beijing.volces.com/images/image-generation/seedream-5-5-multi-round-editing-input.png",
"size": "2K",
"output_format": "png",
"background": "opaque",
"response_format": "url",
"watermark": true
}'
原生 RGBA 图片#
Seedream 5.5 支持通过文生图和图生图直接生成带透明通道的 RGBA 图片。与 Seedream 5.0 pro / flash 相比,Seedream 5.5 扩展了透明背景图片的生成场景和输入范围:
| 对比项 | Seedream 5.5 | Seedream 5.0 pro / flash |
|---|---|---|
| 文生 RGBA 图片 | 支持 | 不支持 |
| 图生 RGBA 图片 | 支持最多输入 10 张参考图 |
支持仅支持输入 1 张参考图 |
| 输入图要求 | 无需带透明通道 | 必须为带透明通道的 PNG 图片 |
调用时,将 background 设置为 transparent,并将 output_format 设置为 png。
文生 RGBA 图片#
不传入 image,并在提示词中描述需要生成的主体和透明背景要求。
| 提示词 | 输出图 |
|---|---|
| 透明亚克力立牌,圣诞主题,矩形轮廓,四周有一圈白色细描边衬托透明基材。整体是手账拼贴风:中心是一张红绿双色黑胶唱片 + 金色边圈,唱片周围环绕立体感的橡果叶片 & 松枝圣诞花环,花环四周点缀着手绘感的红色浆果、金色四角星、驯鹿、雪花小贴纸;下方叠印一条极简白色音乐播放 UI——播放/暂停控制按钮、进度条(01:24 / 04:32)、音量图标。色调以复古红、森林绿、香槟金 + 米白为主。立牌上偶有亚克力厚度带来的高光折射,营造真实产品质感。设为透明背景。 | 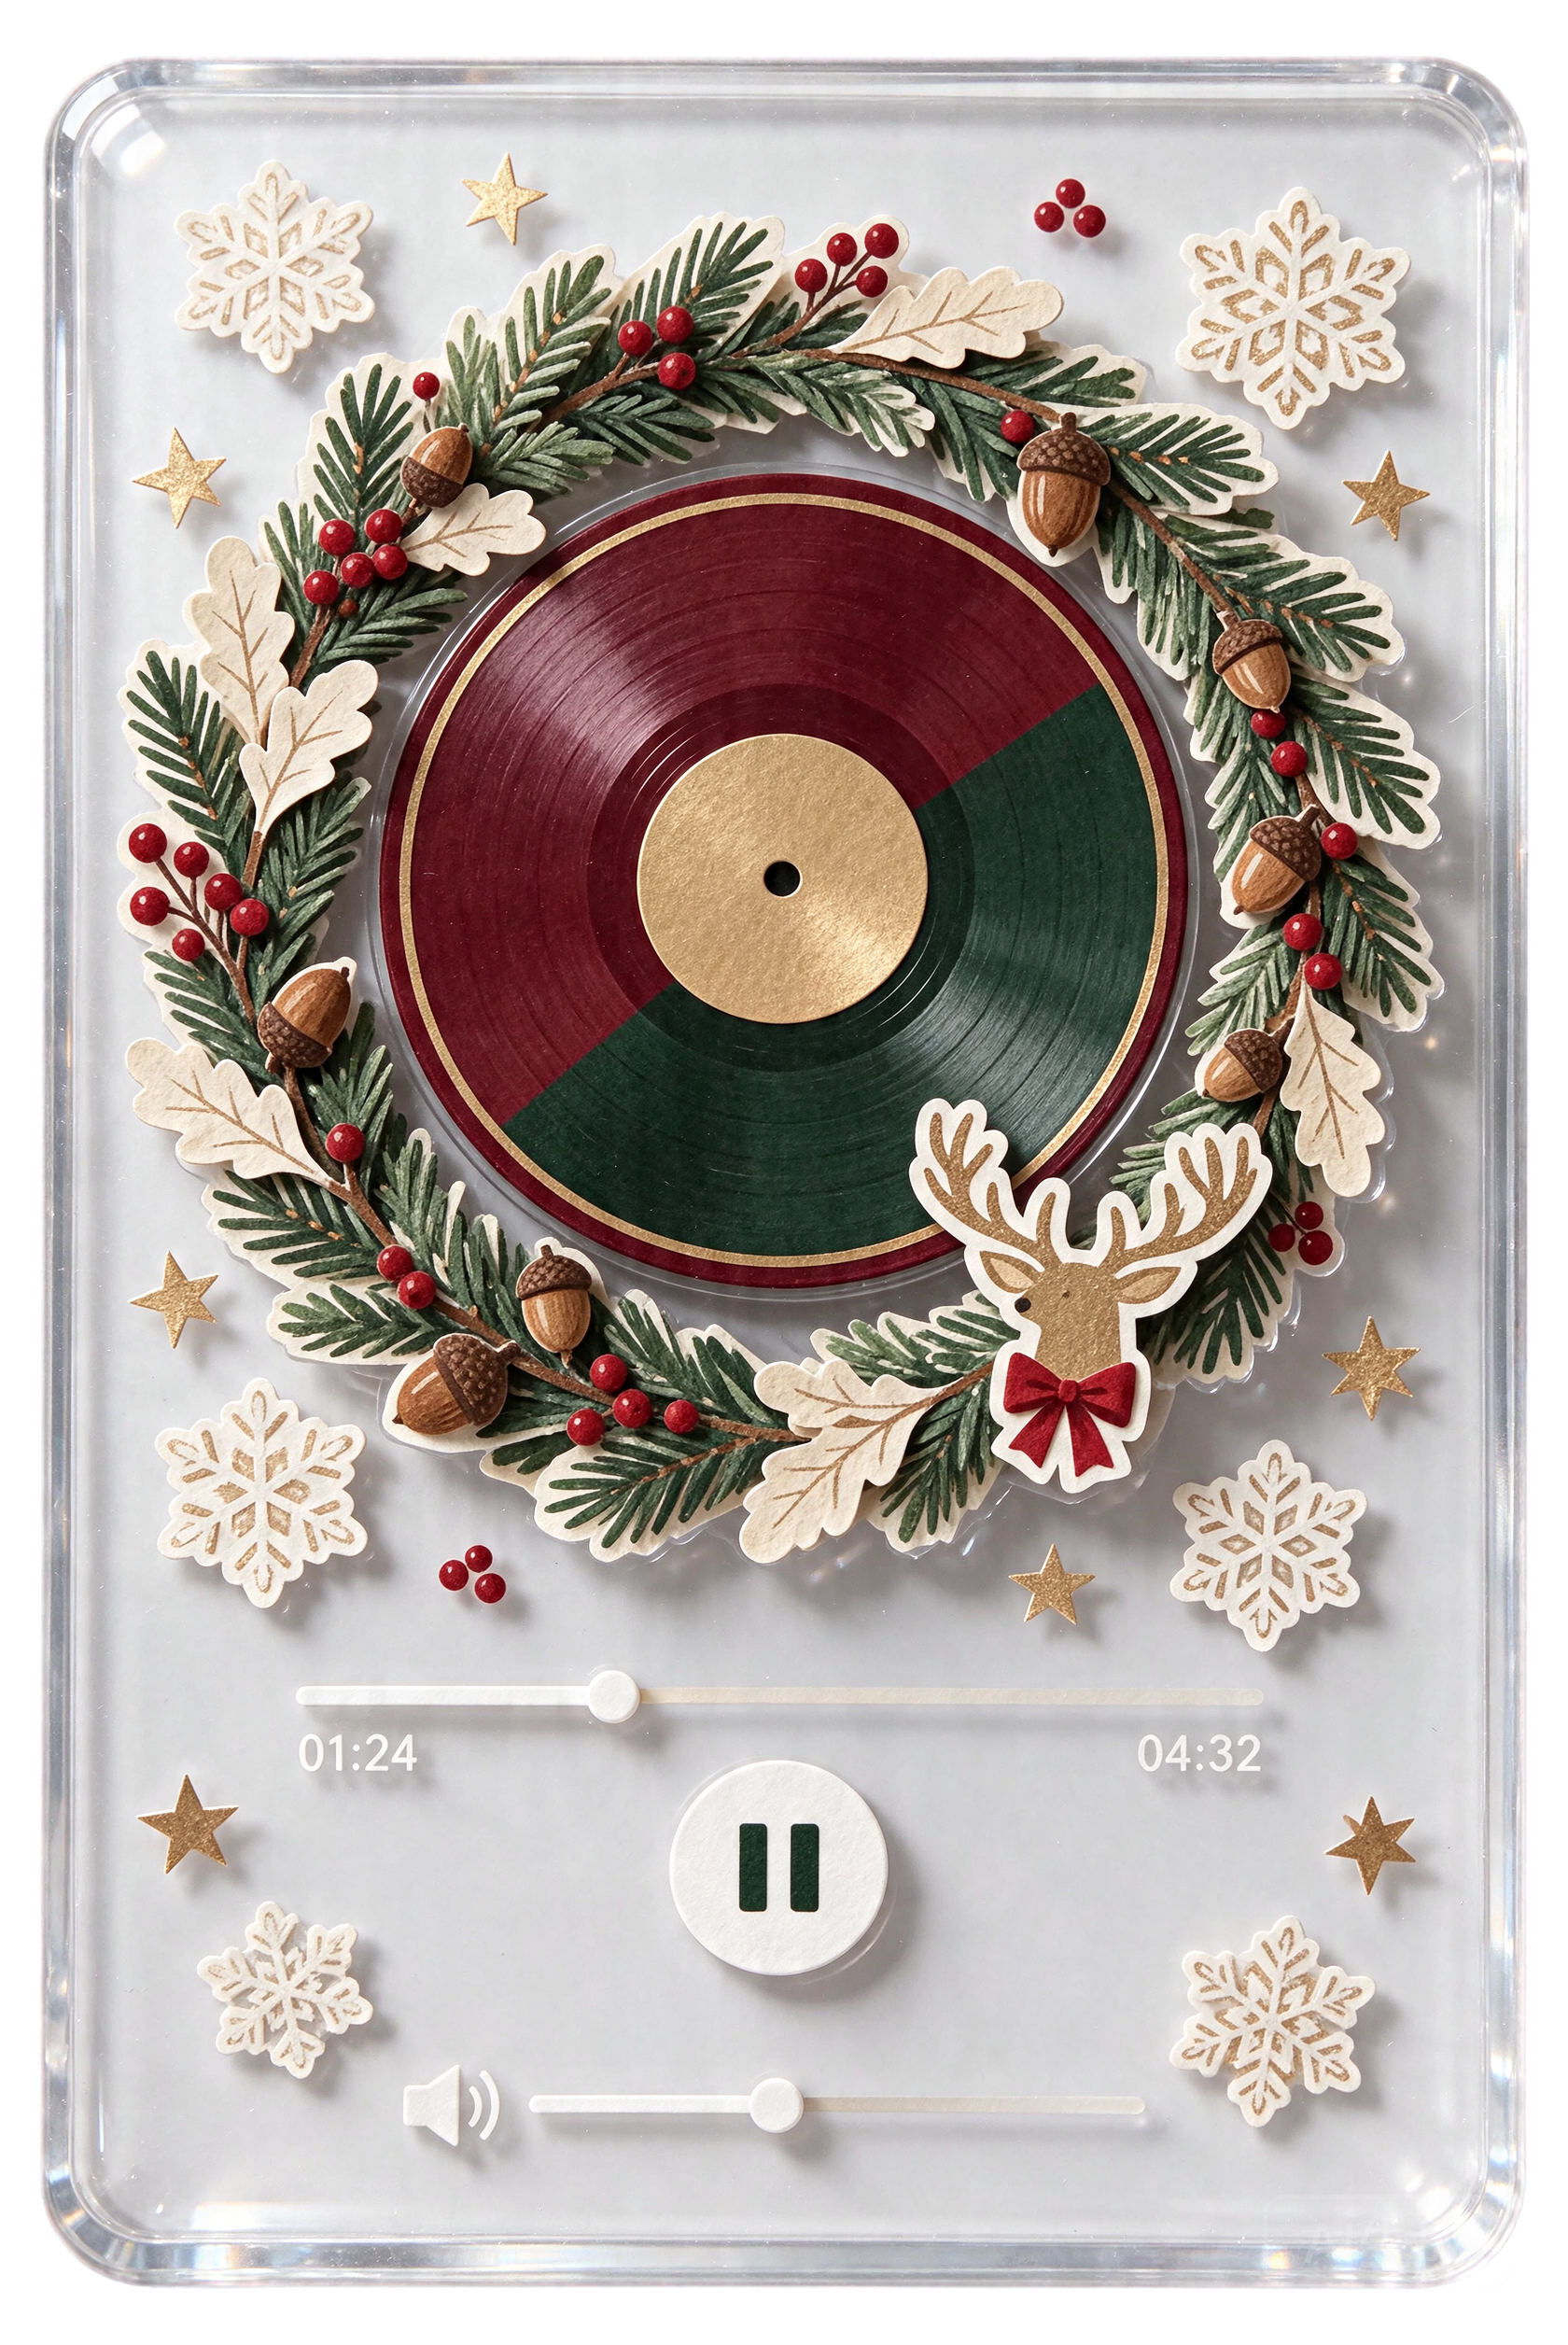 |
curl https://ark.cn-beijing.volces.com/api/v3/images/generations \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $ARK_API_KEY" \
-d '{
"model": "doubao-seedream-5-5-261028",
"prompt": "透明亚克力立牌,圣诞主题,矩形轮廓,四周有一圈白色细描边衬托透明基材。整体是手账拼贴风:中心是一张红绿双色黑胶唱片 + 金色边圈,唱片周围环绕立体感的橡果叶片 & 松枝圣诞花环,花环四周点缀着手绘感的红色浆果、金色四角星、驯鹿、雪花小贴纸;下方叠印一条极简白色音乐播放 UI——播放/暂停控制按钮、进度条(01:24 / 04:32)、音量图标。色调以复古红、森林绿、香槟金 + 米白为主。立牌上偶有亚克力厚度带来的高光折射,营造真实产品质感。设为透明背景。",
"size": "2K",
"output_format": "png",
"background": "transparent",
"response_format": "url",
"watermark": true
}'
图生 RGBA 图片#
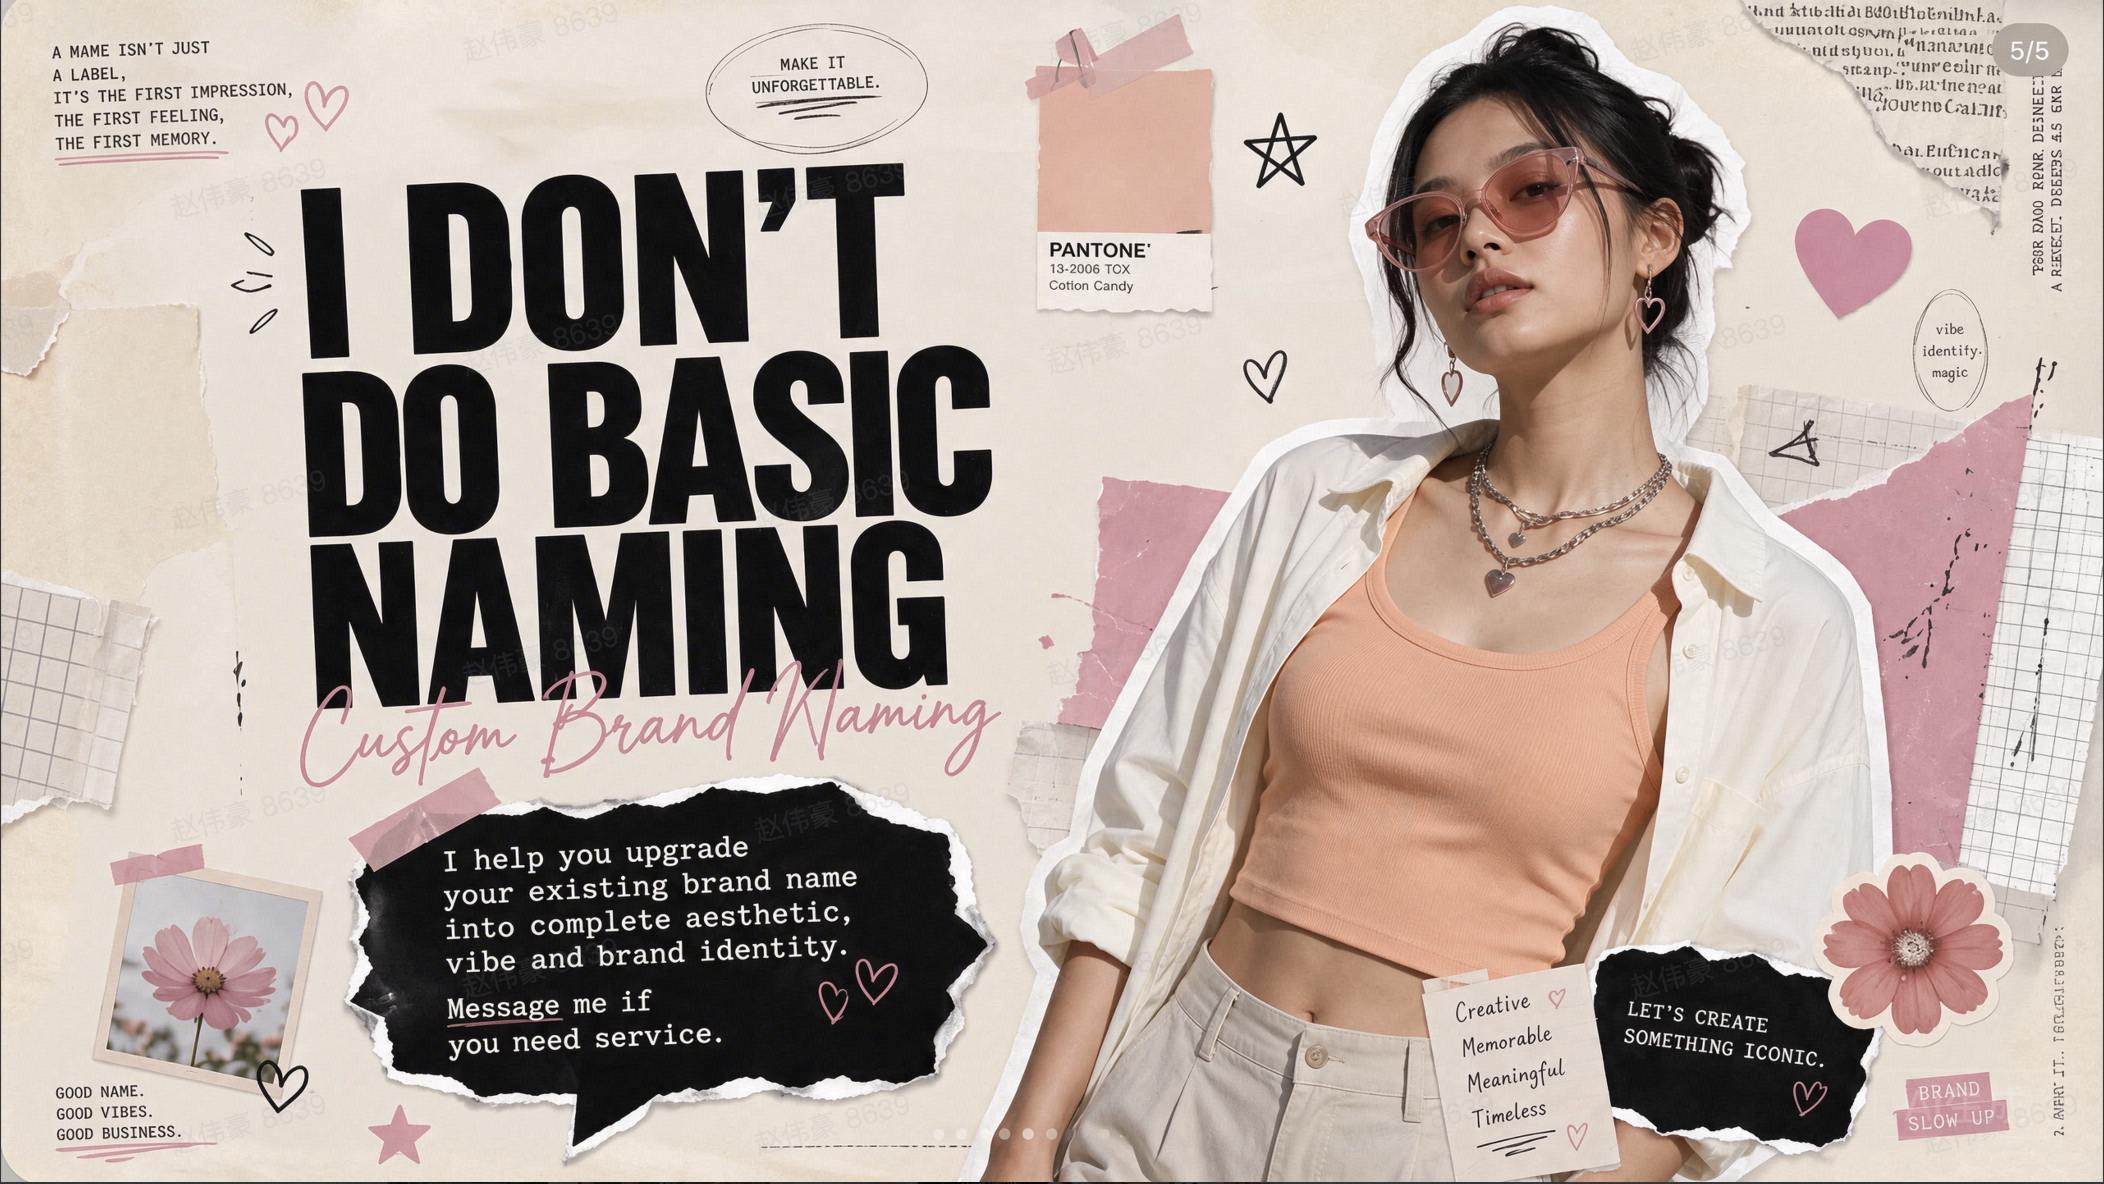
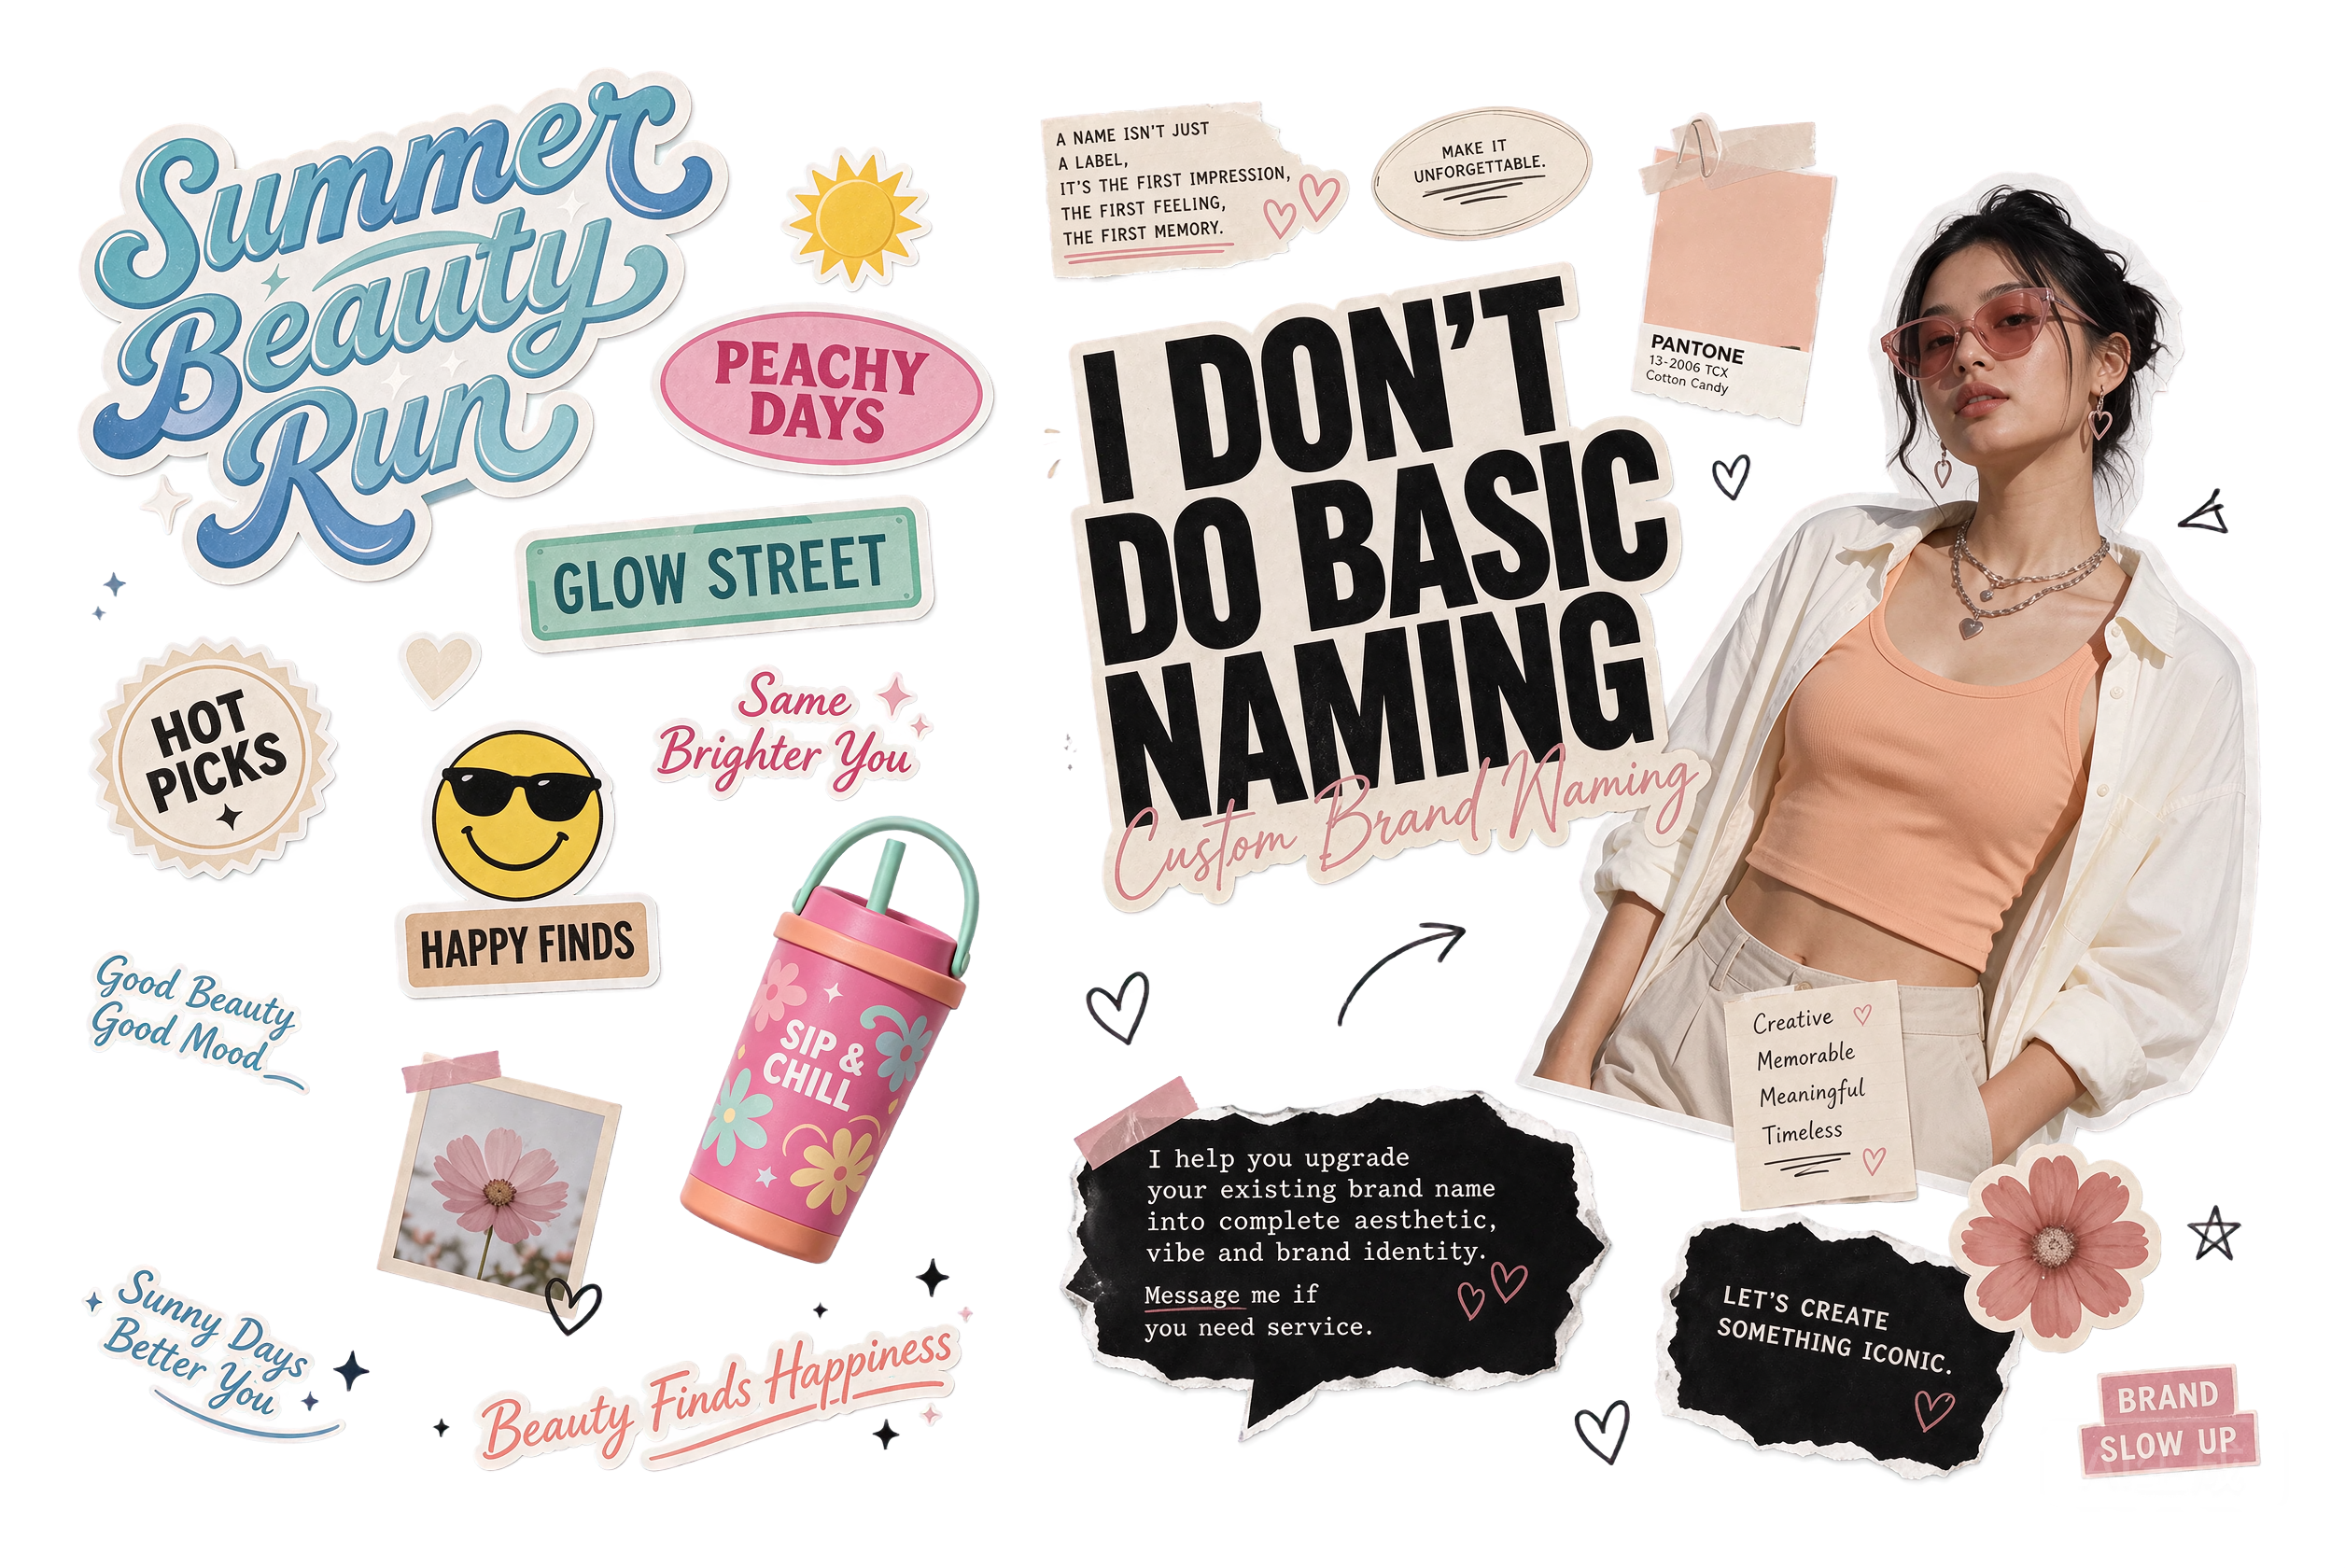
通过 image 传入 1 张参考图,或最多 10 张参考图。以下示例通过数组传入两张参考图,分别提取其中的贴纸元素,并将所有贴纸放在同一张透明背景图片中。
| 提示词 | 输入图 1 | 输入图 2 | 输出图 |
|---|---|---|---|
| 分别提取图1和图2中的贴纸元素,将提取出的所有贴纸放在同一张透明背景图片中。保留每个贴纸原有的文字、颜色、形状和细节,去除贴纸以外的背景;各贴纸独立摆放、互不重叠,边缘清晰完整。 | 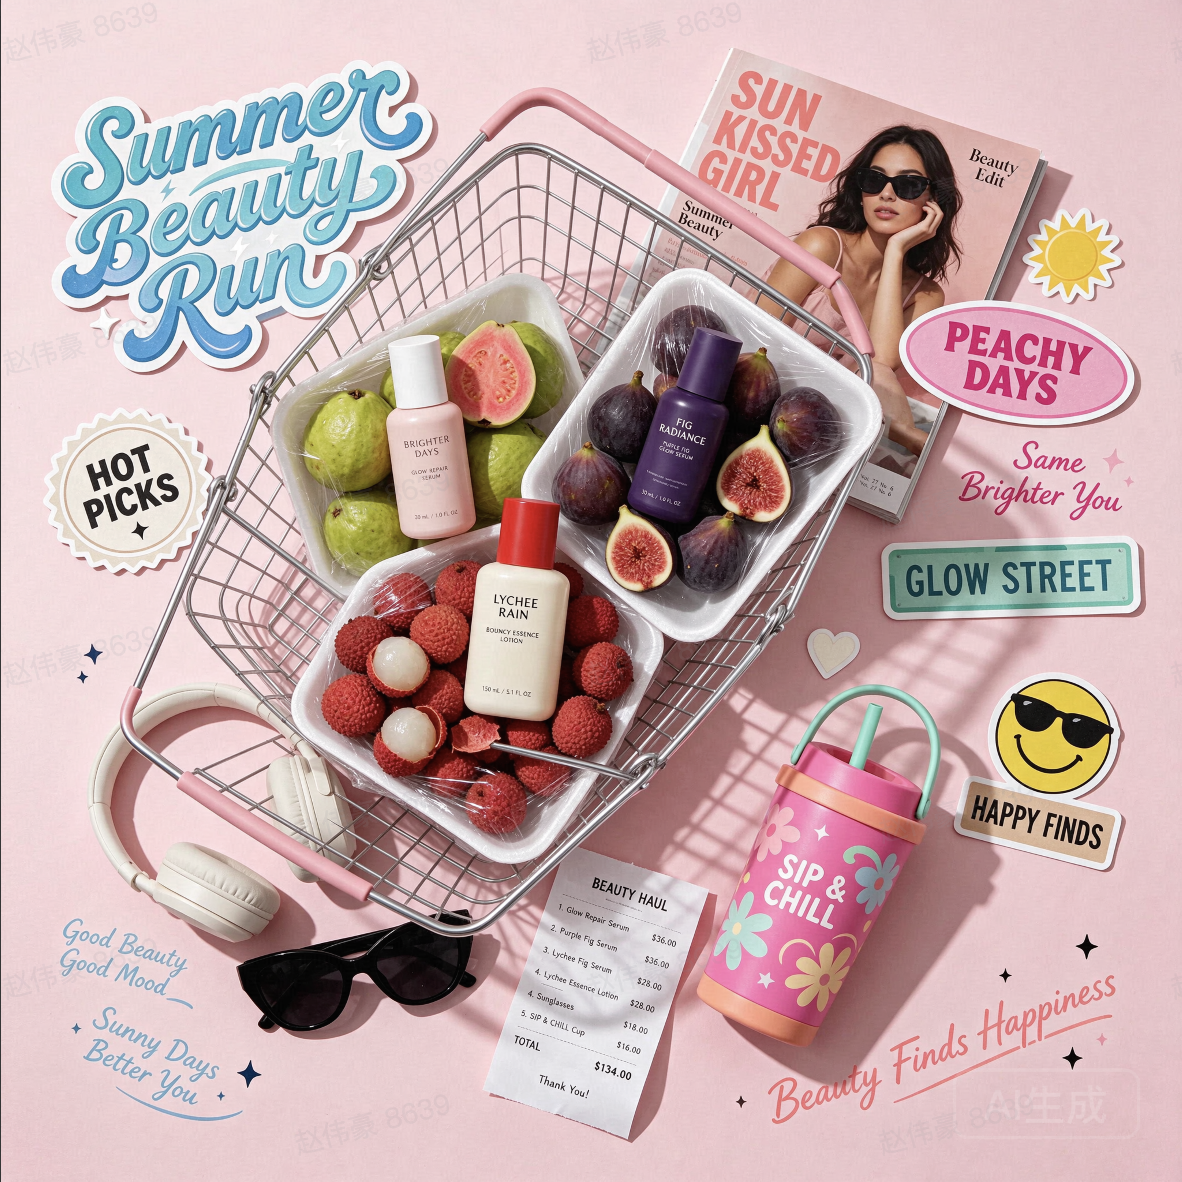 |
 |
 |
curl https://ark.cn-beijing.volces.com/api/v3/images/generations \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $ARK_API_KEY" \
-d '{
"model": "doubao-seedream-5-5-261028",
"prompt": "分别提取图1和图2中的贴纸元素,将提取出的所有贴纸放在同一张透明背景图片中。保留每个贴纸原有的文字、颜色、形状和细节,去除贴纸以外的背景;各贴纸独立摆放、互不重叠,边缘清晰完整。",
"image": [
"https://arkdocs.tos-cn-beijing.volces.com/images/image-generation/ocr-test3.png",
"https://arkdocs.tos-cn-beijing.volces.com/images/image-generation/ocr-test4.png"
],
"size": "2K",
"output_format": "png",
"background": "transparent",
"response_format": "url",
"watermark": true
}'
更精细的图层拆分#
Seedream 5.5 的图层拆分调用方式、提示词写法、图层还原方法与 Seedream 5.0 pro / flash 一致,详情请参见 图层拆分。本节仅介绍 Seedream 5.5 的升级能力。
| 升级能力 | 说明 |
|---|---|
| 拆分更多图层 | 单次请求最多输出 100 张图片,包括 1 张底图和最多 99 个图层。 |
| 设置最大输出图片数 | 通过 layer_decomposition_options.max_images 设置最大输出图片数,包含底图和图层。
拆分规则当提示词未说明如何拆分或描述不清晰时,模型会结合 max_images 和输入图片的复杂度合理规划拆分结果;传入的 max_images 值越大,拆分结果通常越细。 |
效果示例#
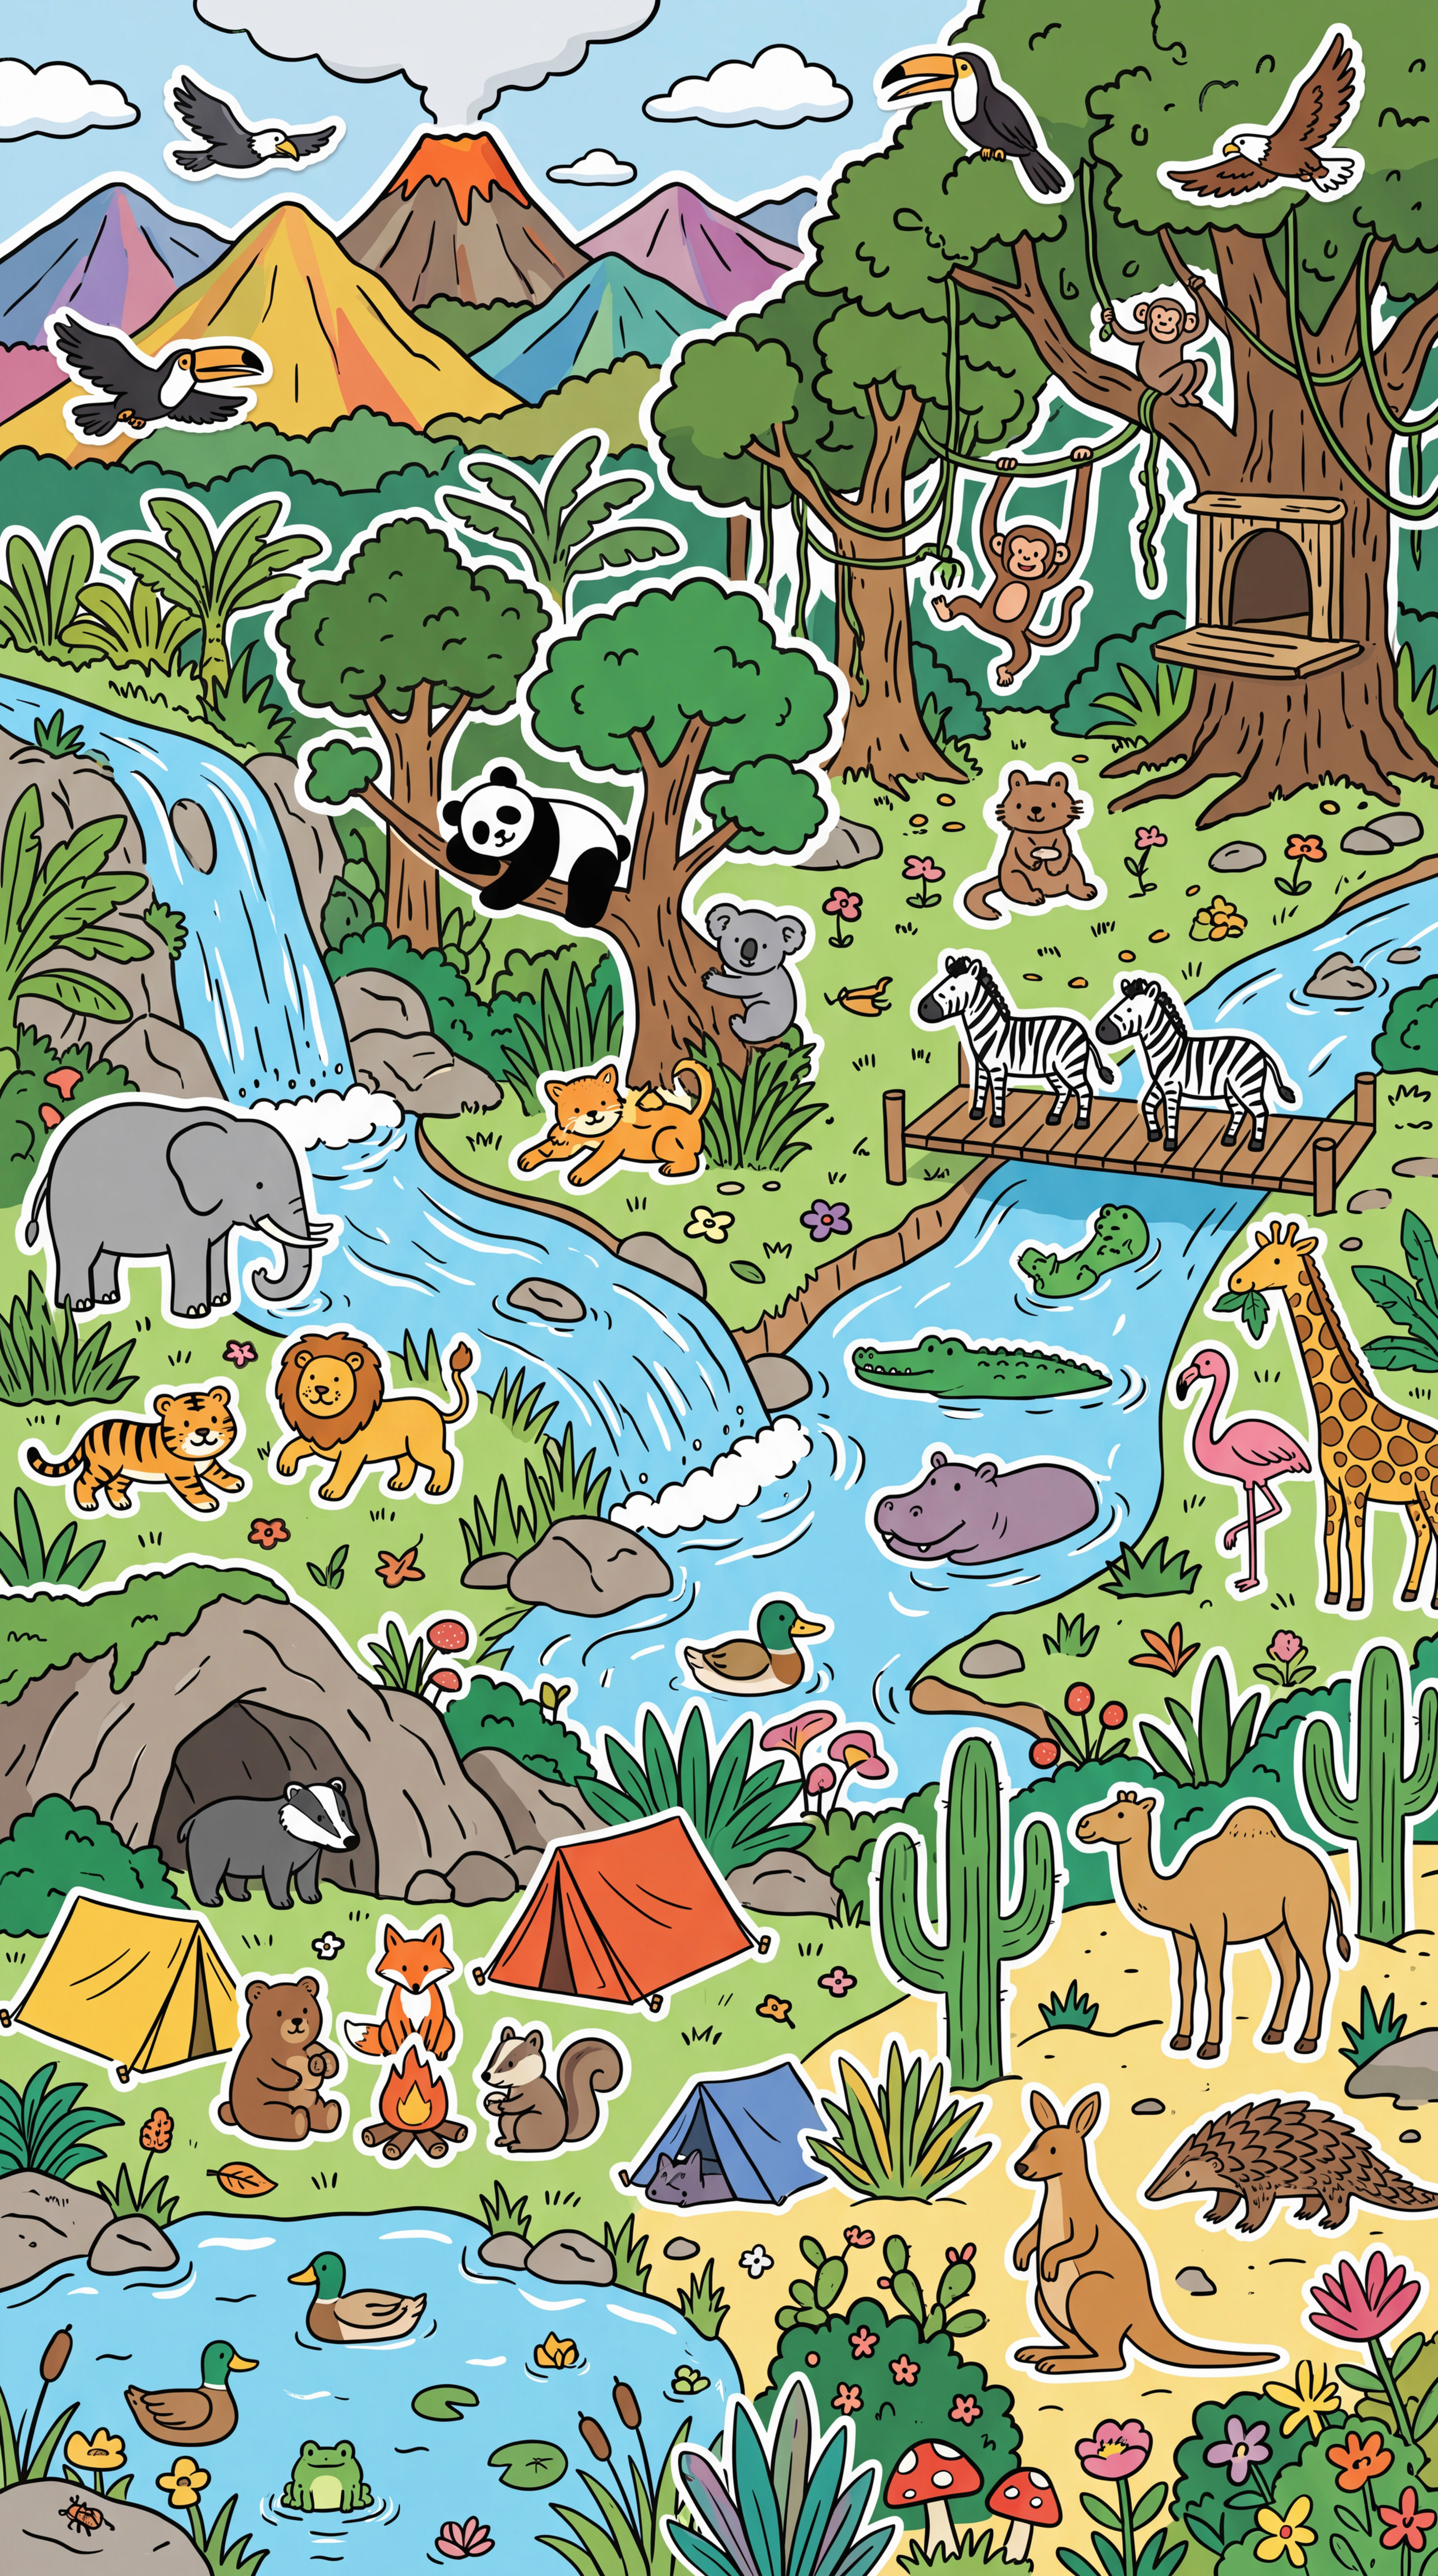
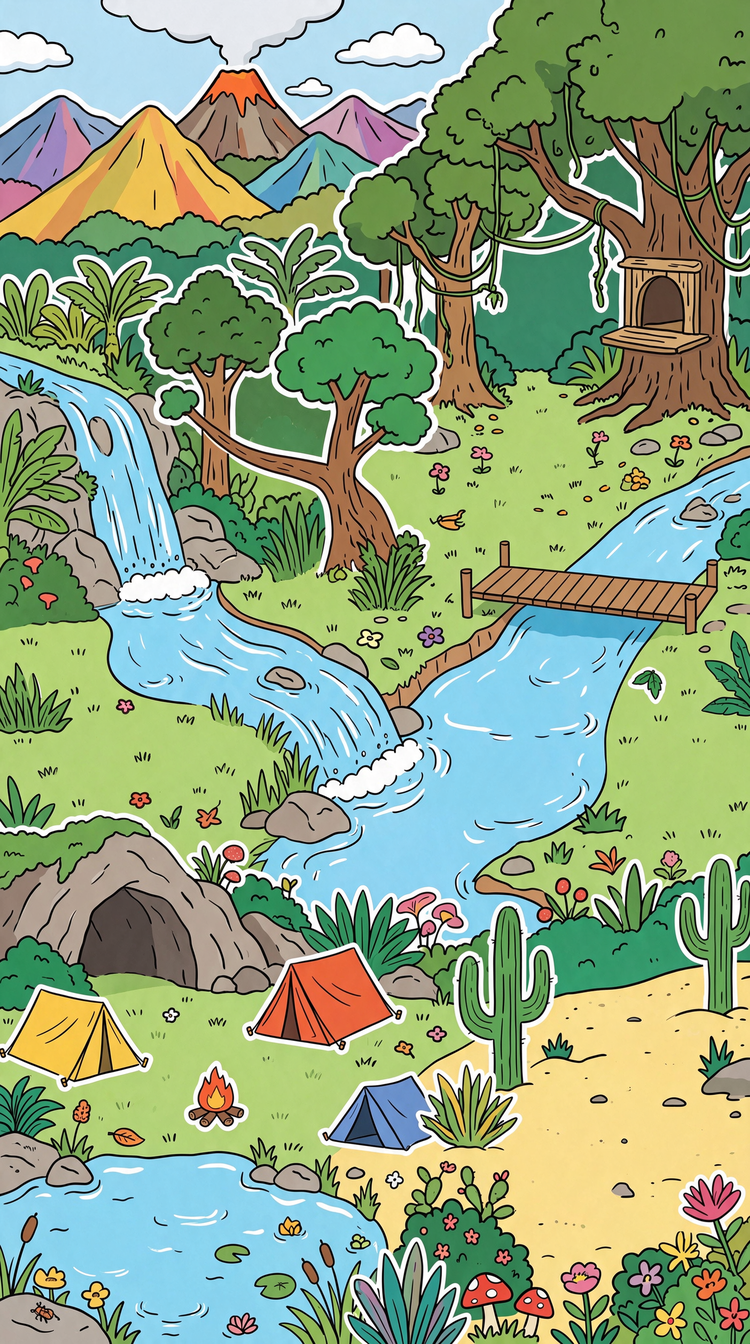
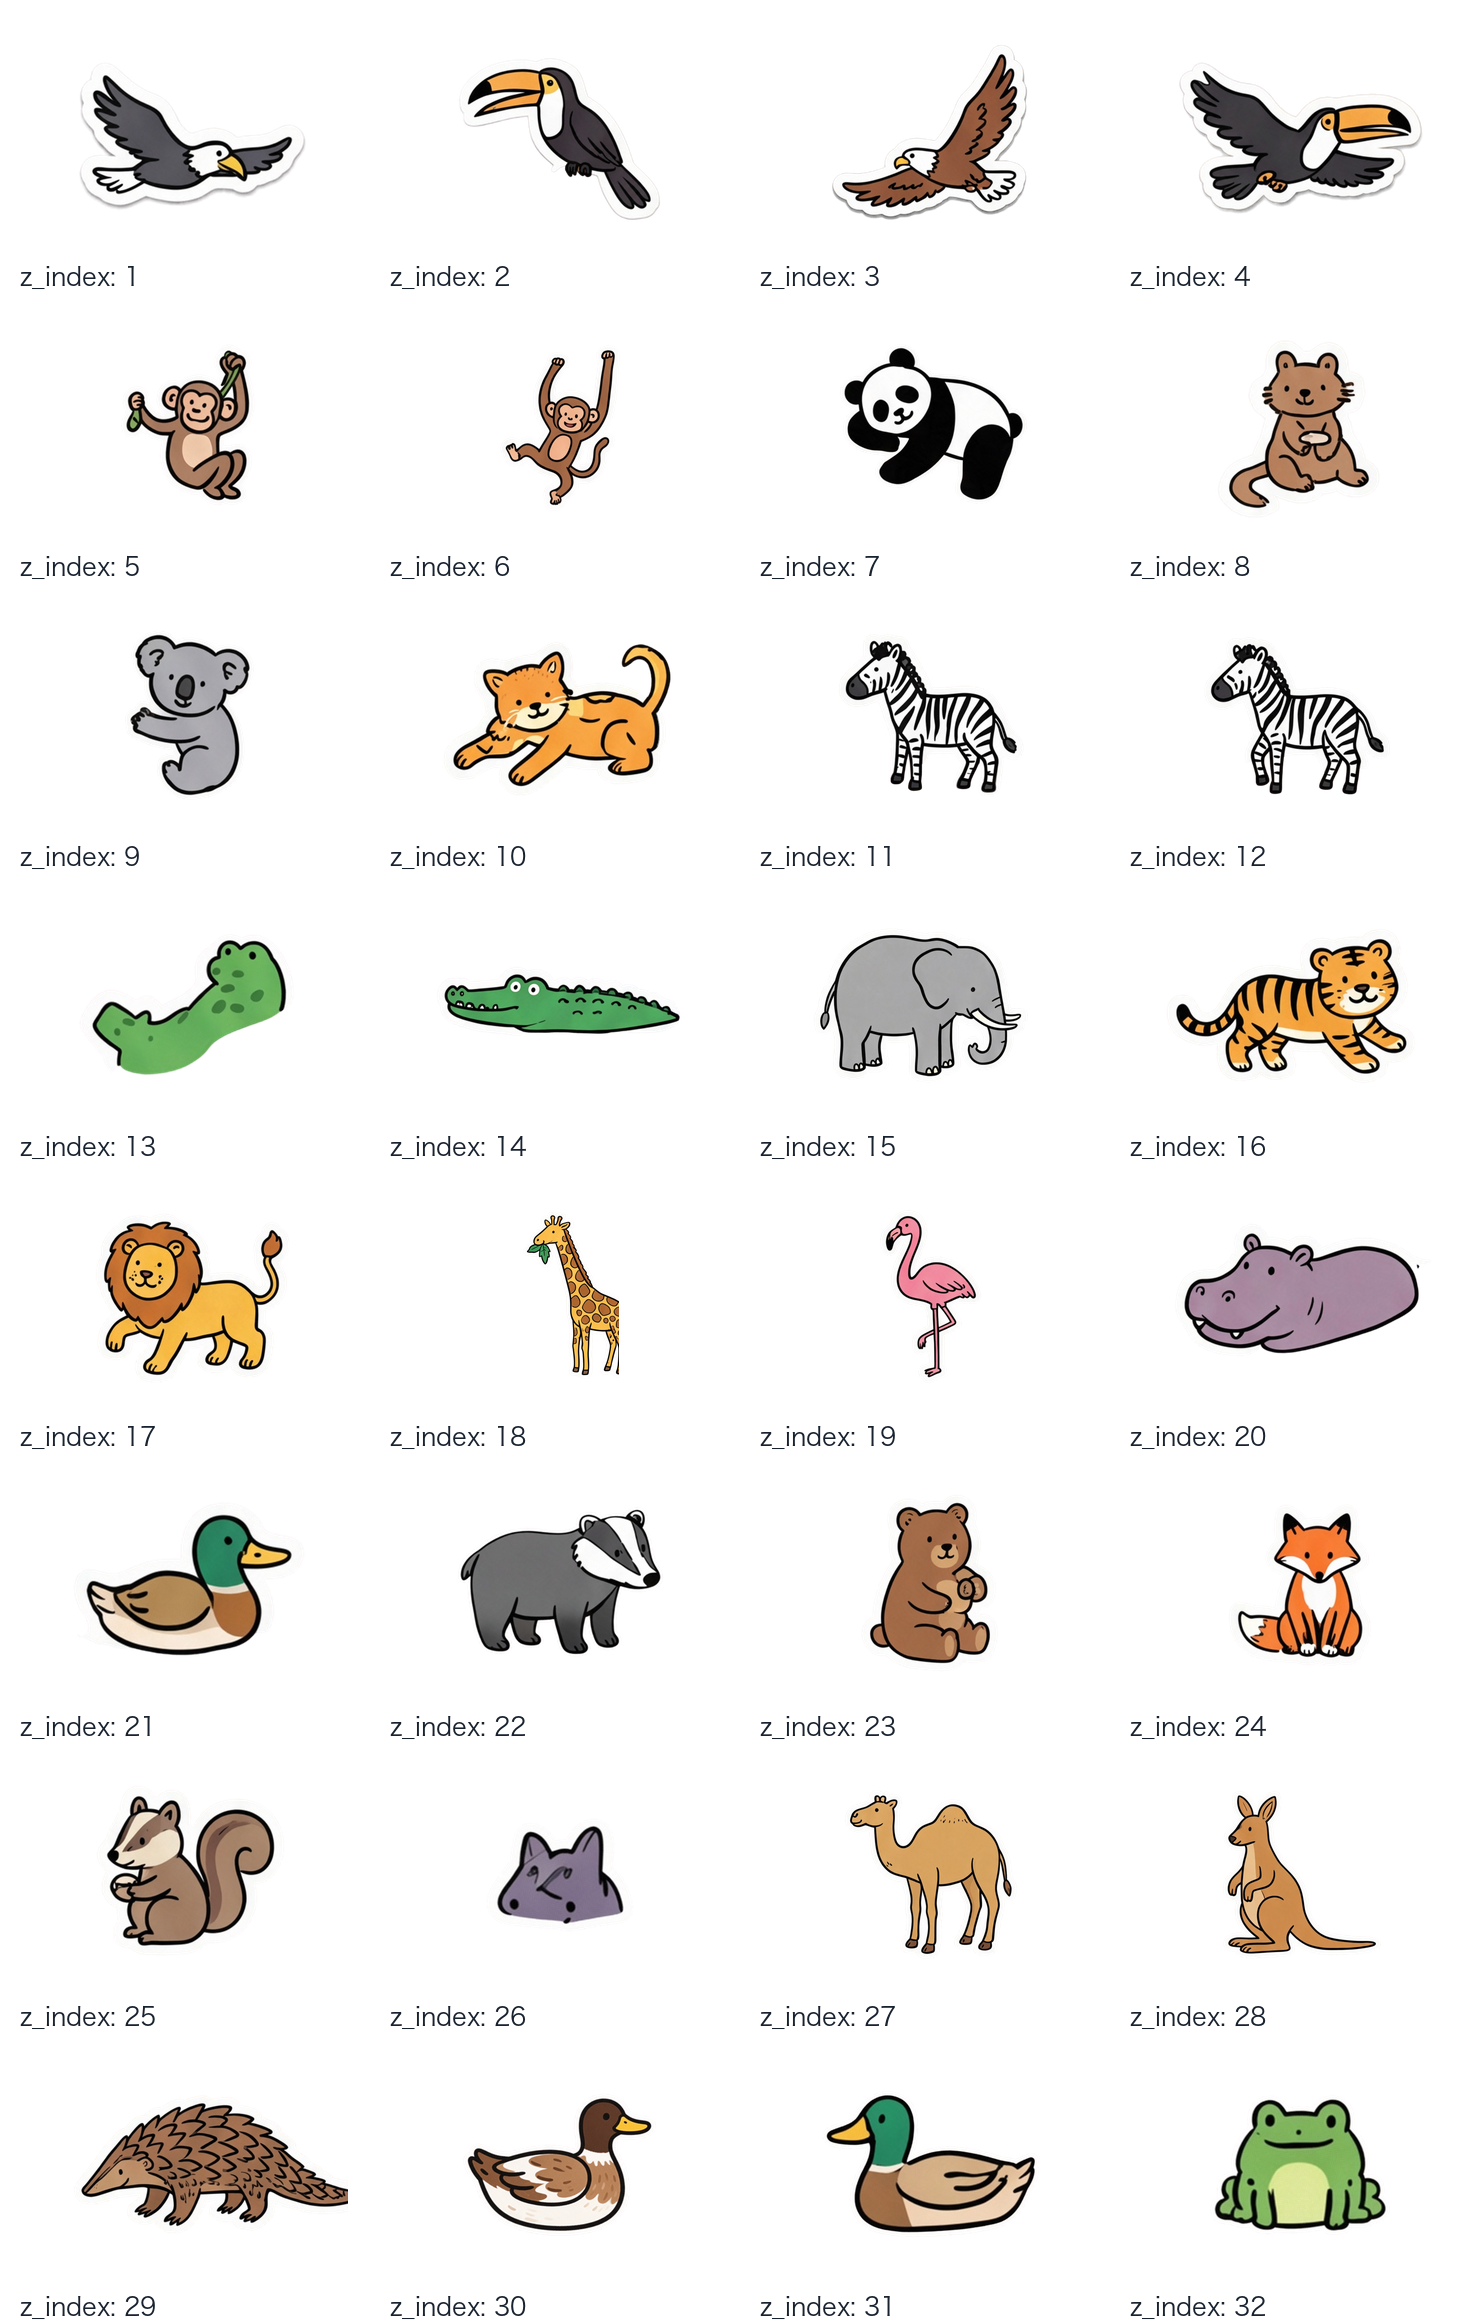
以下示例要求将动物场景插画中的每只动物拆分为独立图层,动物以外的场景元素保留在底图中。请求设置 max_images: 40,本次实际返回 33 张图片,包括 1 张底图和 32 个动物图层。
为便于展示,图层总览将模型输出的 32 个独立图层拼排为一张图片,并非模型直接输出的单张图片。
| 输入图 | 输出底图 | 输出图层总览 |
|---|---|---|
 |
 |
 |
查看完整输出结果
代表图层示例
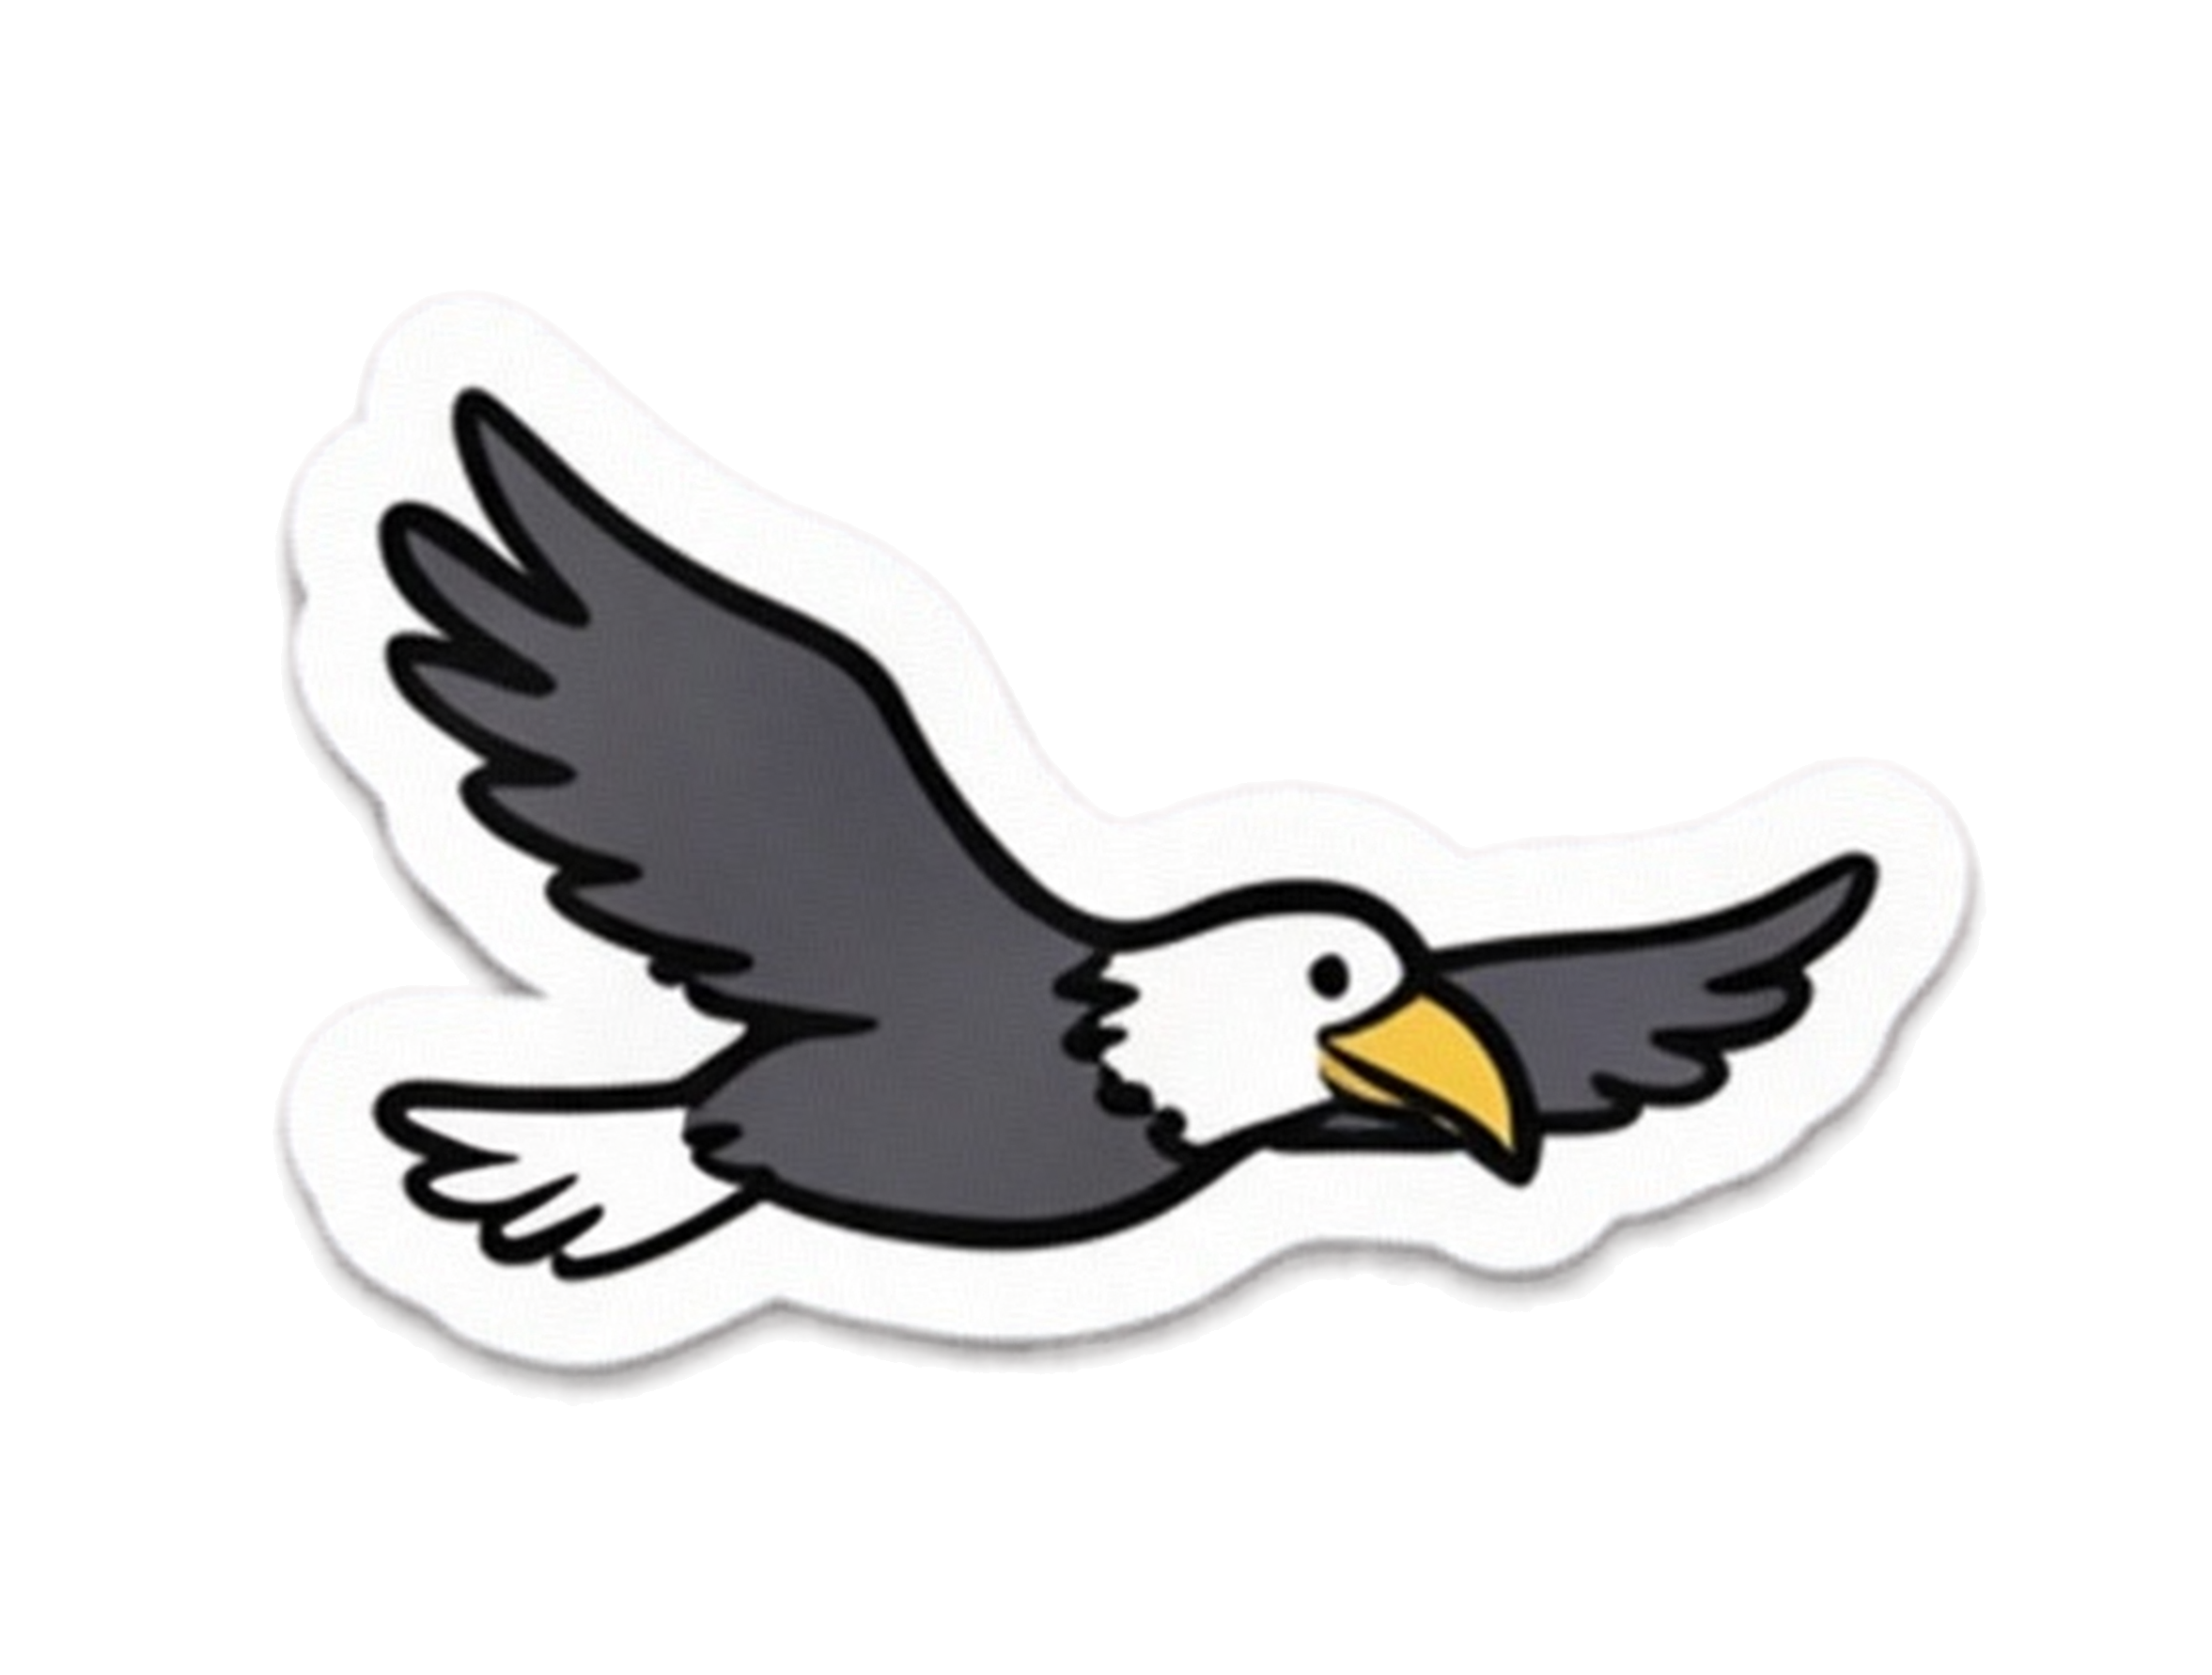
以下展示本次返回的部分原始透明 PNG 图层,编号对应响应中的 z_index。
| 图层 1:白头海雕 | 图层 7:大熊猫 | 图层 11:斑马 |
|---|---|---|
 |
 |
 |
| 图层 17:狮子 | 图层 24:狐狸 | 图层 32:青蛙 |
|---|---|---|
 |
 |
 |
调用示例#
以下代码以上述动物场景插画为输入,展示将每只动物拆分为独立图层的调用方式。
curl "https://ark.cn-beijing.volces.com/api/v3/images/generations" \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $ARK_API_KEY" \
-d '{
"model": "doubao-seedream-5-5-261028",
"prompt": "每只动物作为一个完整的独立图层,同种动物分别拆分;保留造型、颜色、姿态、白色描边及原位置;非动物元素统一保留在底图,并自然补全移除动物后的区域。",
"image": "https://arkdocs.tos-cn-beijing.volces.com/images/image-generation/animal-test.jpeg",
"layer_decomposition": true,
"layer_decomposition_options": {
"max_images": 40,
"text_recognition": true
},
"size": "2K",
"output_format": "png",
"response_format": "url",
"watermark": true
}'
提取文字图层的内容和样式(富文本 OCR)#
Seedream 5.5 支持在图层拆分时,为规整文字图层返回富文本 OCR 结果,包括文字内容、逐行位置和近似视觉样式。这些信息可与拆分后的图层结合,供设计工具或应用实现文字修改、本地化和模板复用。文字编辑与图层合成由工具或应用完成。
效果示例#
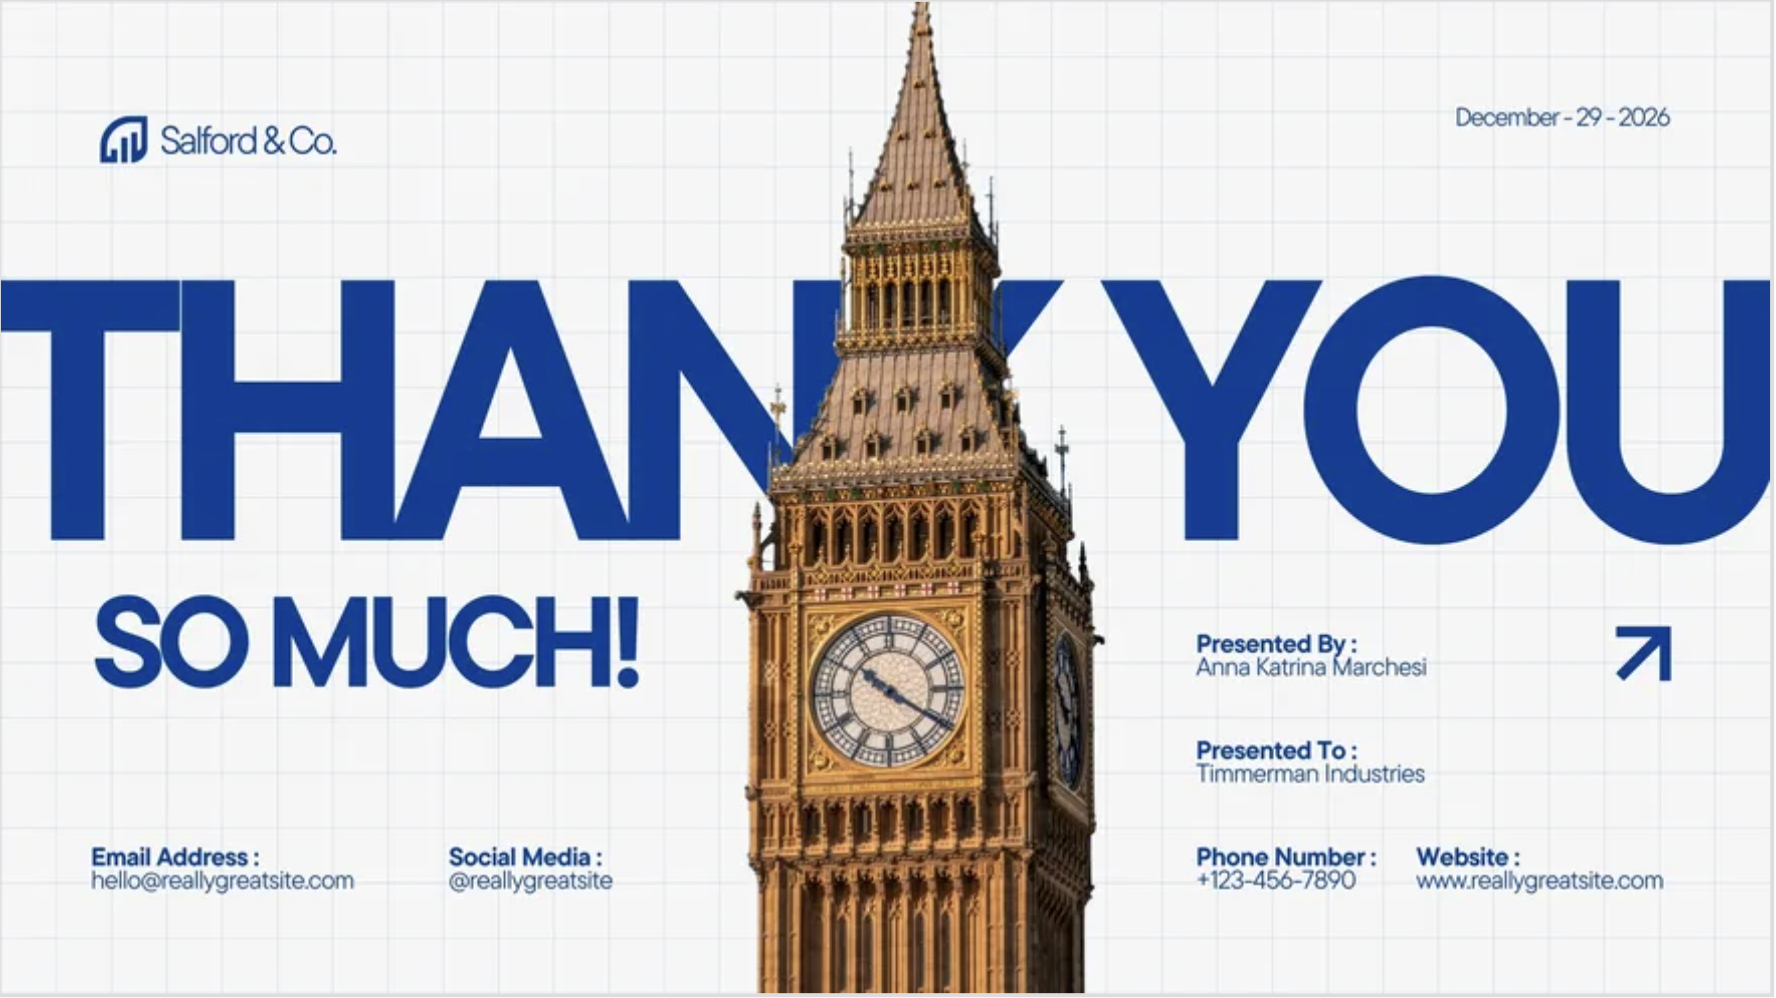
以下示例将一张海报拆分为独立图层,并获取文字图层的 OCR 结果。请求设置 max_images: 15,实际返回 13 张图片,包括 1 张底图和 12 个图层。其中,9 个文字图层返回了 OCR 结果。
| 输入图 | 文字图层 | OCR 识别结果 |
|---|---|---|
 |
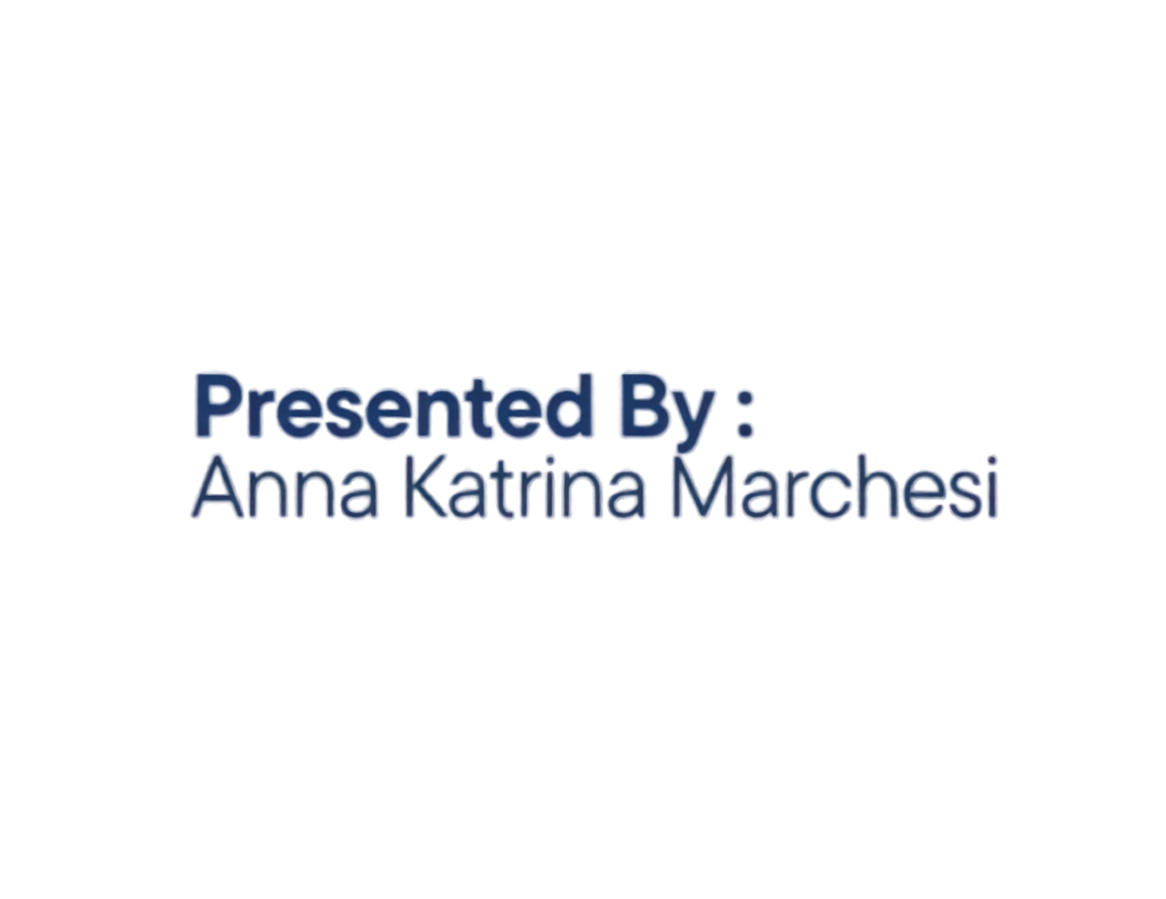 |
文字:
颜色:
|
查看全部拆分结果
输出底图
返回 OCR 结果的图层
以下编号对应本次响应中的 z_index。
| 图层 2:日期 | 图层 3:标题文字“THANK YOU” | 图层 5:标题文字“SO MUCH!” |
|---|---|---|
 |
 |
 |
| 图层 6:演示者 | 图层 8:获赠者 | 图层 9:邮箱 |
|---|---|---|
|
 |
 |
| 图层 10:社交媒体 | 图层 11:电话号码 | 图层 12:网站 |
|---|---|---|
 |
 |
 |
未返回 OCR 结果的图层
| 图层 1:品牌标识 | 图层 4:建筑主体 | 图层 7:箭头 |
|---|---|---|
 |
 |
 |
开启 OCR 识别#
使用 Seedream 5.5 进行图层拆分时,需配置以下参数:
- 图层拆分:将
layer_decomposition设置为true,开启图层拆分模式。 - 文字识别:将
layer_decomposition_options.text_recognition设置为true,获取规整文字图层的 OCR 结果。
curl https://ark.cn-beijing.volces.com/api/v3/images/generations \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $ARK_API_KEY" \
-d '{
"model": "doubao-seedream-5-5-261028",
"prompt": "将图片中的元素拆分成独立图层",
"image": "https://arkdocs.tos-cn-beijing.volces.com/images/image-generation/ocr-test2.png",
"layer_decomposition": true,
"layer_decomposition_options": {
"max_images": 15,
"text_recognition": true
},
"size": "auto",
"output_format": "png",
"response_format": "url",
"watermark": true
}'
OCR 识别结果说明#
模型通过 data[].text_recognition 返回当前文字图层的 OCR 结果,包括完整纯文本,以及按文字行和样式片段组织的位置、文字和样式信息。下表说明各字段的层级及含义。
完整字段定义、坐标规则和返回结构请参见 图片生成 API。
| 响应层级 | 字段名 | 含义 |
|---|---|---|
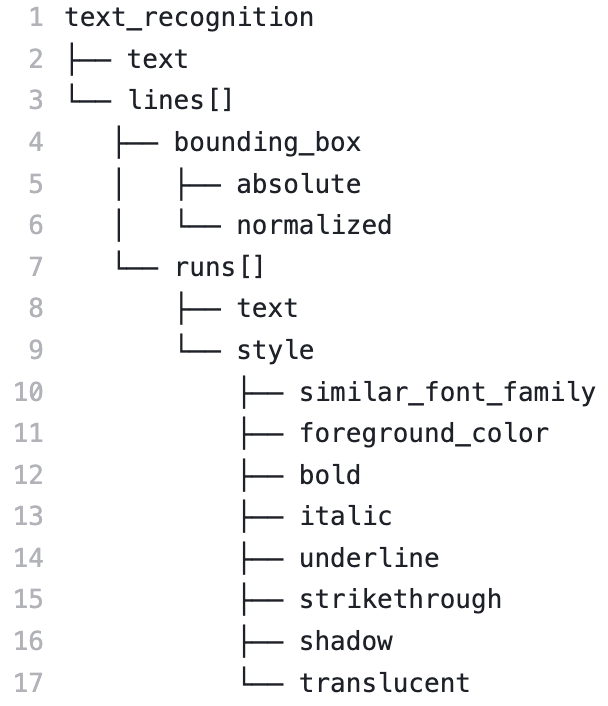 |
text_recognition |
当前文字图层的富文本 OCR 结果。 |
text_recognition.text |
当前图层的完整纯文本,按从上到下、从左到右的顺序排列,行间以 \n 分隔。 |
|
text_recognition.lines[] |
按顺序排列的文字行列表,每个元素对应一行文字,包含位置和样式片段。 | |
lines[].bounding_box |
文字行在输出底图坐标系中的边界框信息,包含绝对坐标 absolute 和归一化坐标 normalized。用于将文字还原至底图或目标画布中的边界框区域。坐标换算方法参见 还原与重组图层。 |
|
bounding_box.absolute |
文字行边界框在输出底图坐标系中的绝对像素坐标,格式为 [left, top, right, bottom]。输出底图左上角为 (0, 0),可用于还原文字行在底图中的位置。 |
|
bounding_box.normalized |
文字行边界框按输出底图宽高换算至 [0, 1000] 区间的归一化整数坐标,格式为 [left, top, right, bottom],可用于换算文字行在目标画布中的位置。 |
|
lines[].runs[] |
当前文字行的样式片段列表,每个片段内的样式一致。整行样式一致时仅包含一个片段;字体、颜色、粗体等样式变化时,包含多个片段。 | |
runs[].text |
当前片段的文字内容,不包含换行符,可用于定位和替换文案。 | |
runs[].style |
当前文字片段的近似视觉样式,包含以下 8 个字段。样式由模型自动识别,可能与原始设计文件中的精确属性存在偏差。 | |
style.similar_font_family |
模型根据文字外观匹配出的最相似字体名称,不保证与原字体完全一致。无法识别或置信度不足时返回 unknown。 |
|
style.foreground_color |
当前文字片段的颜色,使用大写十六进制 #RRGGBB 格式,不包含 Alpha(透明度)通道。 |
|
style.bold |
是否识别到当前文字片段使用粗体样式。 | |
style.italic |
是否识别到当前文字片段使用斜体样式。仅字形本身向右倾斜时返回 true;图层整体旋转或透视倾斜不视为斜体。 |
|
style.underline |
是否识别到当前文字片段带有文字下划线。独立的分割线、表格线或装饰横线不视为下划线。 | |
style.strikethrough |
是否识别到当前文字片段带有删除线。 | |
style.shadow |
是否识别到当前文字片段带有明显的外投影、阴影或发光偏移。文字边缘的常规抗锯齿过渡不视为阴影。 | |
style.translucent |
是否识别到文字墨迹本身明显半透明,并能透出下方背景纹理或底色。实心的浅灰色、浅蓝色等浅色文字不视为半透明。 |
文字图层响应示例
以下示例对应上方“效果示例”中包含 Presented By : 和 Anna Katrina Marchesi 的文字图层(z_index: 6)。示例展示该图层 data[] 项的部分字段,其中 text_recognition 为完整的 OCR 结果,可与表中的字段层级对应查看。
{
"size": "1166x899",
"z_index": 6,
"bounding_box": {
"absolute": [1142, 528, 1474, 784],
"normalized": [643, 529, 830, 786]
},
"text_recognition": {
"text": "Presented By : \nAnna Katrina Marchesi",
"lines": [
{
"bounding_box": {
"absolute": [1196, 629, 1358, 658],
"normalized": [673, 630, 765, 659]
},
"runs": [
{
"text": "Presented By : ",
"style": {
"similar_font_family": "Helvetica Neue",
"foreground_color": "#193366",
"bold": true,
"italic": false,
"underline": false,
"strikethrough": false,
"shadow": false,
"translucent": false
}
}
]
},
{
"bounding_box": {
"absolute": [1195, 651, 1427, 681],
"normalized": [673, 652, 803, 682]
},
"runs": [
{
"text": "Anna Katrina Marchesi",
"style": {
"similar_font_family": "Helvetica Neue",
"foreground_color": "#46597E",
"bold": false,
"italic": false,
"underline": false,
"strikethrough": false,
"shadow": false,
"translucent": false
}
}
]
}
]
},
"background": "transparent"
}
使用限制#
- 识别范围:仅规整文字图层返回 OCR 结果,支持字体范围详见 Seedream 5.5 OCR 支持字体。底图、非文字图层,以及艺术字、手写体等非规整文字图层不返回
text_recognition。 - 字体识别:模型通过
similar_font_family返回相似字体,不保证与原字体完全一致。无法识别或置信度不足时返回unknown。 - 样式识别:样式信息为近似识别结果,可能与原始设计属性存在偏差。布尔字段为
false表示模型未识别到对应样式。
自定义图片输出规格#
您可以配置以下参数来控制图片输出规格:
- size:指定输出图片的尺寸。
- response_format:指定生成图片的返回方式。
- output_format:指定图片文件格式;图层拆分场景下,仅控制底图的文件格式。
- background:仅适用于图片生成场景,控制是否生成带透明通道的图片。
- watermark:指定是否为输出图片添加水印。
图片输出尺寸#
size 参数在图片生成场景和图层拆分场景下的可选值与默认值不同,请根据实际场景选择。
图片生成场景
支持以下两种方式,不可混用。
方式 1:指定分辨率档位(推荐)
在 prompt 中用自然语言描述图片宽高比、图片形状或图片用途,最终由模型判断生成图片的大小。
- 默认值:
2K - 可选值:
1K、1.5K、2K
方式 2:指定宽高像素值(宽x高)
- 总像素取值范围:[
1280x720(921600),2048x2048x1.1025(4624220)] - 宽高比取值范围:[1/16, 16]
| 方式 1 | 方式 2 |
|---|---|
|
|
图层拆分场景
仅支持通过指定分辨率档位的方式进行设置。输出图的分辨率规则如下:
- 底图:输出底图的分辨率和
size指定的分辨率一致;输出底图和原待拆分图的宽高比一致。 - 各图层:输出图层的分辨率和
size指定的分辨率接近;每个输出图层和其在原图中的宽高比一致。
size 的默认值与可选值:
- 默认值:
auto - 可选值:
1K、1.5K、2K、auto(根据输入图的尺寸和宽高比进行输出)
各档位的宽高像素映射和 auto 适配规则,请参见 Image generation API。
图片返回方式#
设置 response_format 参数,可以指定生成图片的返回方式:
url(默认值):返回图片下载链接。链接在图片生成后 24 小时内有效,请及时下载或转存。b64_json:通过响应中的b64_json字段返回 Base64 编码的图片数据。
图片文件格式#
设置 output_format 参数,指定生成图片的文件格式:
png(默认值)jpeg
图片背景类型#
设置 background 参数,控制生成图片是否包含透明通道。
auto(默认值):模型根据提示词和output_format自动判断背景类型。若output_format为jpeg,输出图片不含透明通道。transparent:输出带透明通道的图片(RGBA 图)。opaque:输出不含透明通道的图片(RGB 图)。
图片中添加水印#
设置 watermark 参数,控制是否在生成的图片中添加水印。
默认值:true。
false:不添加水印。true:在图片右下角添加“AI 生成”字样的水印标识。
使用限制#
SDK 版本升级
为保证模型功能正常使用,请务必升级至最新 SDK 版本。相关步骤请参见 安装及升级 SDK。
图片传入限制
图片传入方式(两种场景通用):
-
图片 URL:请确保图片 URL 可被访问。
示例:
https://arkdocs.tos-cn-beijing.volces.com/images/image-generation/seedream-5-5-transparent-input.png -
Base64 编码:请遵循格式
data:image/<图片格式>;base64,<Base64 编码>。注意:<图片格式>必须采用小写字母,例如data:image/png;base64,<base64_image>。
不同场景对输入图片的约束不同,详见下表:
| 约束项 | 图片生成场景 | 图层拆分场景 |
|---|---|---|
| 图片格式 | jpeg、png、webp、bmp、tiff、gif、heic、heif | png、jpeg |
| 总像素(宽×高) | [196, 6000×6000(3600 万)] |
[512×512(262144), 6000×6000(3600 万)] |
| 宽高长度(px) | 大于 14 | — |
| 宽高比(宽/高) | [1/16, 16] | [1/16, 16] |
| 大小 | 不超过 30 MB | 不超过 30 MB |
| 传入张数 | 最多传入 10 张参考图 | 仅支持传入单张图 |
保存时间
图片 URL 仅保留 24 小时,超时后会被自动清除。请及时保存生成的图片。
限流说明
- IPM 限流:账号下同模型(区分模型版本)每分钟生成图片数量上限。若超过该限制,生成图片时会报错。
- 图层拆分场景下,每次请求按
max_images的值预扣减 IPM;图片全部生成后,按实际生成数量返还多扣减的额度。
- 图层拆分场景下,每次请求按
- 不同模型的限制值不同,详见 图片生成能力。