


开通管理介绍#
在 开通管理页,您可以清晰了解当前商品的开通状态、免费额度消耗情况、模型用量上限使用情况、推理输入/输出定价、LoRA精调定价、全量精调定价、模型级别限流。可以在当前页面配置开通/关闭服务、查看模型的接入文档。
开通模型服务#
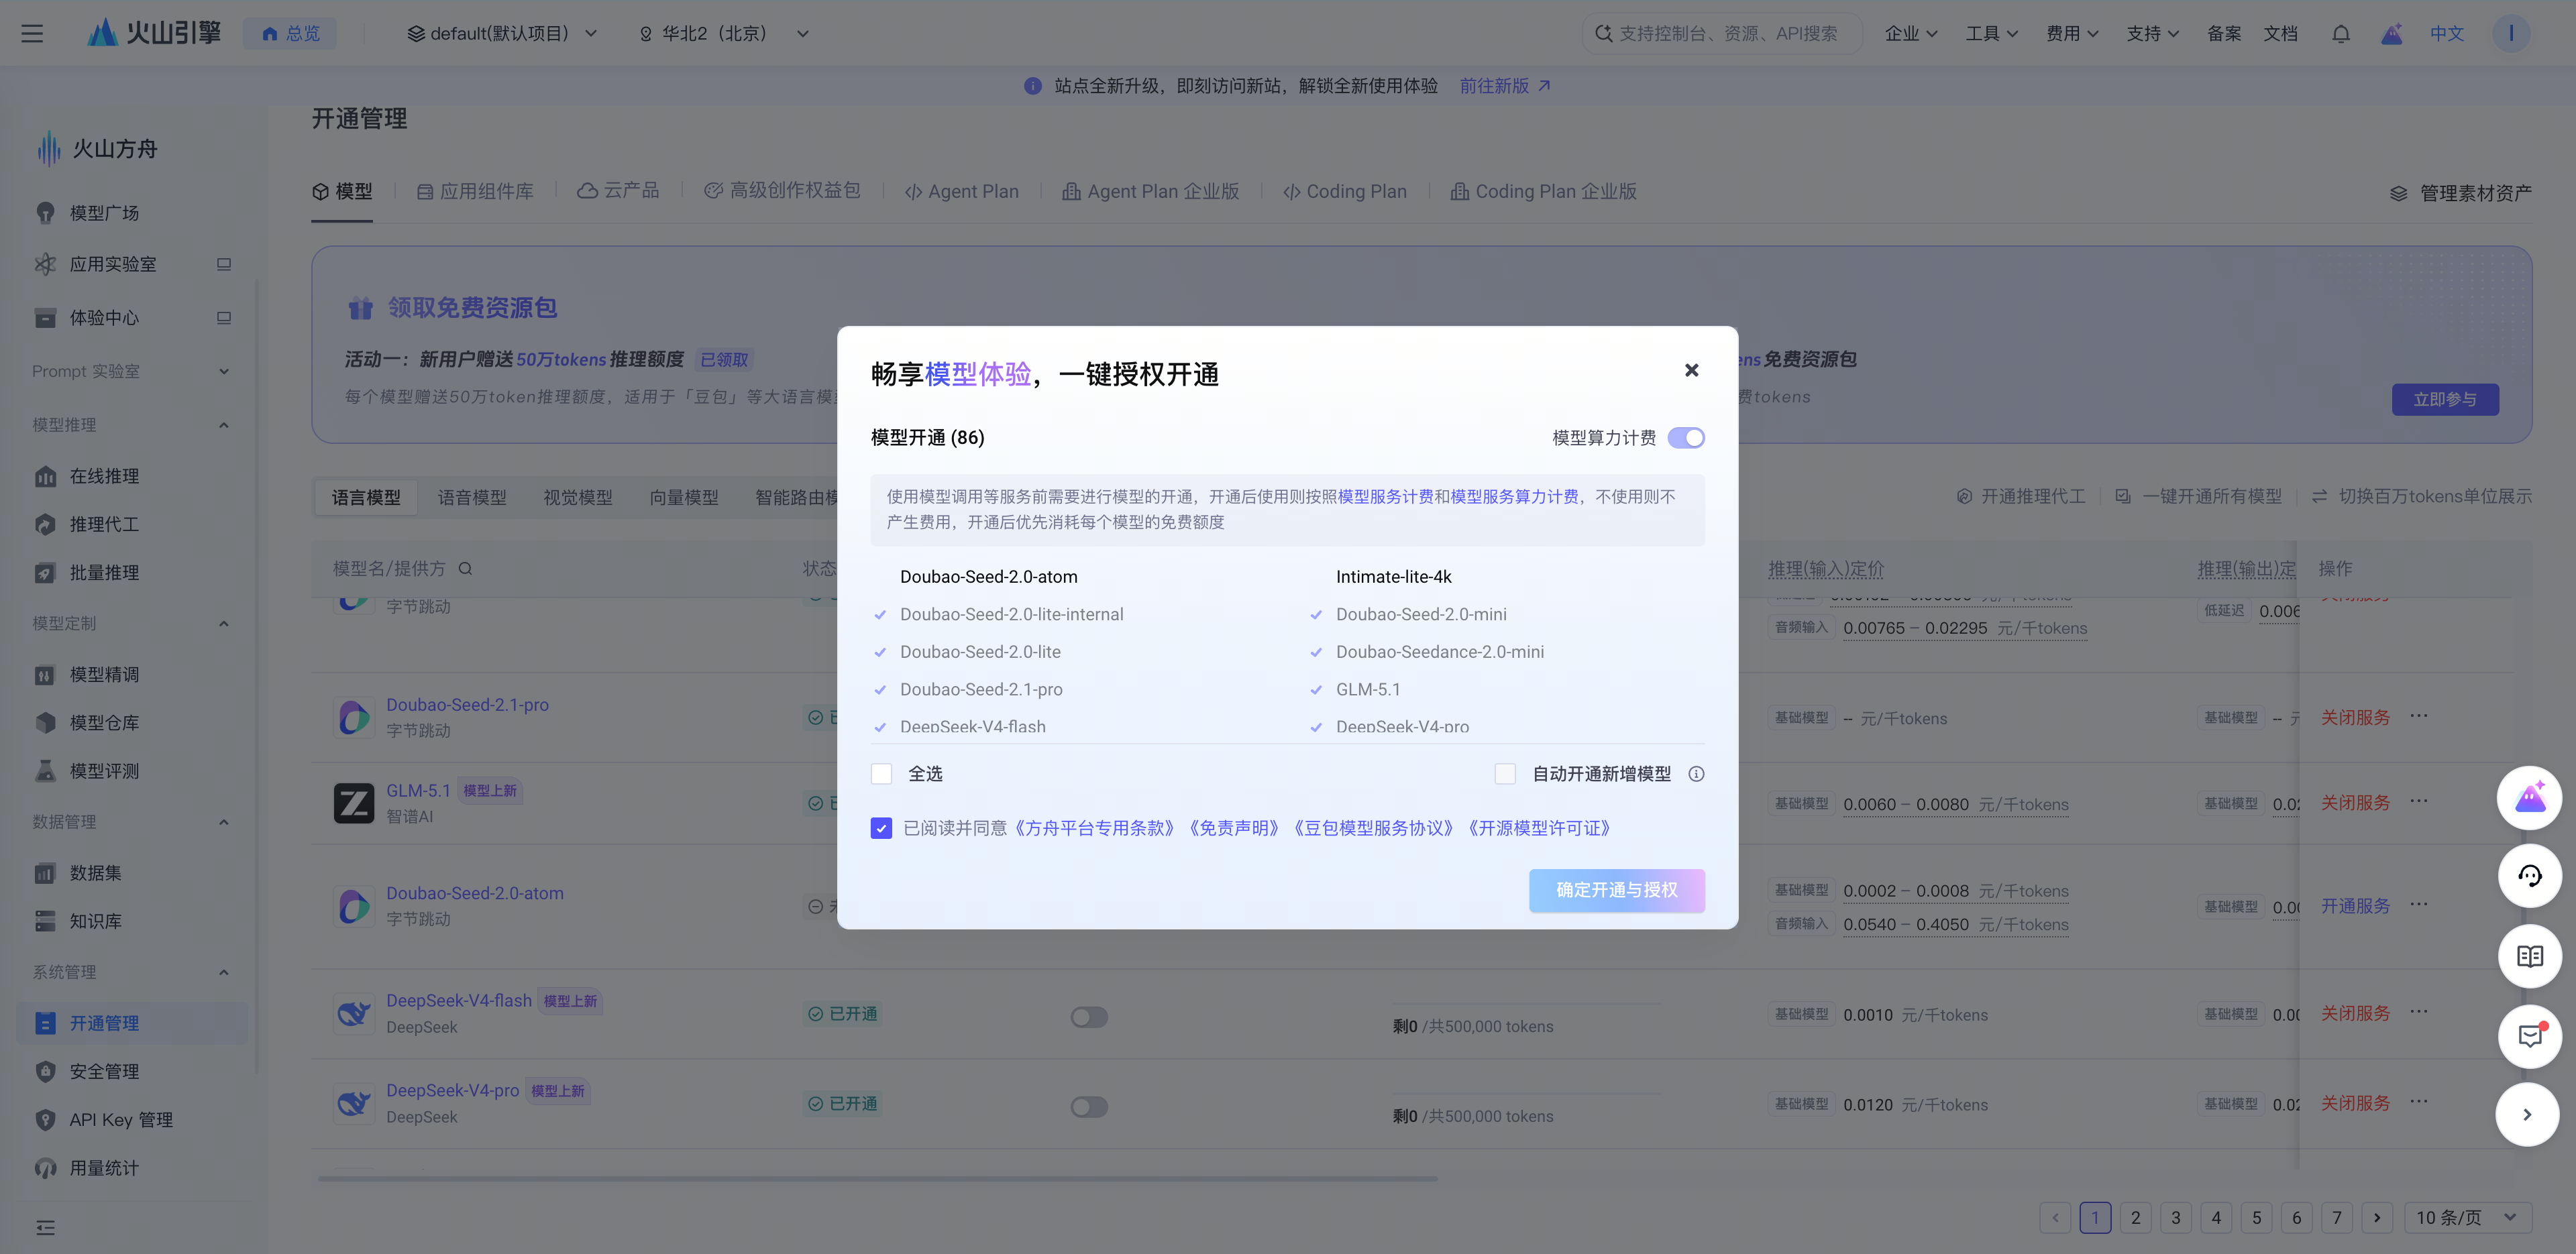
点击目标模型的开通服务按钮,在弹窗中勾选全选及自动开通新增模型。开启后,系统将自动为后续新增且支持自动开通的模型开通服务。
Doubao-Seed-Evolving 模型不在自动开通范围内,如需使用,请在开通管理页手动开通模型服务。
开通状态说明#
| 状态 | 说明 |
|---|---|
| 未开通 | 暂未开通该模型服务,每个模型提供一定额度的免费调用额度,未开通前可使用免费额度,免费额度消耗完后可在 开通管理 页中开通模型,并继续付费使用,开通服务后仍优先消耗剩余免费额度 |
| 已开通 | 已正式开通模型服务 |
| 邀测中 | 当前模型为邀测阶段,暂无法支持自助开通使用,如需正式开通使用的,请 提交工单 联系我们。 |
免费额度说明#
每个模型提供一定额度的免费调用量,免费额度消耗完后可在 开通管理 页中开通模型,并继续付费使用,开通服务后仍优先消耗剩余免费额度。
安心体验模式说明#
安心体验模式是针对未开通过模型服务的新用户更方便体验免费额度设计的,可以保障您免费体验模型推理服务,又不产生费用。在安心体验模式下,您调用推理 API 时仅消耗平台赠送的 50w token 免费额度,接近免费额度后服务将暂停,避免产生额外费用。详情请参见 安心体验模式细则说明。
用量上限设置#
为控制模型调用量、减少超用扣费风险,火山方舟提供两级用量上限:
| 类型 | 作用范围 | 设置入口 |
|---|---|---|
| 模型用量上限 | 账号下同一模型的所有推理接入点共享该上限。 | 开通管理页,为目标模型设置。 |
| 接入点用量上限 | 单个推理接入点的用量上限,避免多接入点抢占或单接入点异常影响业务。 | 推理接入点创建页 或 接入点详情页。 |
从用量上限生效时间起计算(可在控制台查看生效时间),达到上限后将自动暂停对应模型服务/接入点服务。请注意评估服务中断的风险。错误码详情参见 错误码。
模型用量上限#
在 开通管理页 为目标模型设置模型用量上限值。账号下该模型累计用量(图片生成模型按张数,其他模型按 tokens)达到上限后,平台将自动暂停该模型服务。
接入点用量上限#
在 推理接入点创建页 或接入点详情页,为单个推理接入点设置用量上限。当该接入点累计用量达到上限后,平台将自动暂停该接入点服务(同模型下其他接入点不受影响)。
功能限制#
- 适用范围限制:模型用量上限、接入点用量上限均仅适用于在线推理场景,不支持批量推理。
- 兼容性限制:
- 前缀缓存功能与模型用量上限、接入点用量上限均不可同时启用。
- 接入点用量上限 与 低延迟(Fast)推理 互斥:开启其一后另一开关不可用。
- 模型类型限制:语音、多模态向量化模型暂不支持设置用量上限。
- 付费模式限制:
- 仅支持为已开通且按 token 后付费 / 按张数后付费的模型或接入点设置用量上限。
- 若模型的推理接入点已购买 TPM 保障包或模型单元,暂不支持设置用量上限。
模型级别限流说明#
当前对每个账号下的每个基础模型设置了RPM(Requests Per Minute,每分钟请求数)及TPM(Tokens Per Minute,每分钟tokens数量)的调用限制。
如需提升模型级别限流,可 提交工单 联系我们。
定价说明#
定价详见产品计费文档:产品计费