


概述#
火山方舟精调 SDK 是火山方舟为开发者提供的 通过编程方式创建和管理大模型精调任务的工具包 ,旨在为需要定制化、自动化精调流程的用户提供灵活、高效的操作入口。区别于控制台的图形化操作,开发者可通过 SDK 将精调任务创建和管理流程集成至本地或第三方系统,实现精调任务的代码化管理,尤其适用于需要结合自定义函数(如奖励函数、Rollout函数)的强化学习场景。
通过精调 SDK,您可以完成授权登录、项目初始化、Rollout / Grader Plugin 编写与调试、可用训练超参查询、精调任务创建、训练轨迹与自定义函数日志查看,以及通过控制台或 CLI 管理任务和模型产物。
目前精调SDK支持的模型及训练方式如下:
| foundation_model | customization_type(训练方式) | ||||||||
|---|---|---|---|---|---|---|---|---|---|
| name 模型名 |
model_version 模型版本 |
FinetuneSft 全量-SFT |
FinetuneLoRA LoRA-SFT |
DPO 全量-DPO |
DPOLoRA LoRA-DPO |
GRPO 全量-GRPO |
GRPOLoRA LoRA-GRPO |
OPDLoRA LoRA-OPD蒸馏 |
OPD 全量-OPD蒸馏 |
| doubao-seed-2-0-mini | 260428【推荐】 | ✅已支持 | ✅已支持 | ✅已支持 | ✅已支持 | ✅已支持 | ✅已支持 | ✅已支持 | ✅已支持 |
| doubao-seed-2-0-lite | 260428【推荐】 | ✅已支持 | ✅已支持 | ✅已支持 | ✅已支持 | ✅已支持 | ✅已支持 | ✅已支持 | ✅已支持 |
以下是您可以参考的精调SDK入门流程
精调 SDK安装与环境准备#
前提条件#
- 您已注册火山引擎账号并完成实名认证,具体步骤参见 账号注册 及 实名认证
- 您已在火山方舟控制台开通目标模型服务、精调算力计费项及依赖的云产品(TOS-数据存储、KMS-数据及模型加密、TLS-日志及轨迹存储、veFaaS-运行plugin函数)。
| 开通模型服务、精调算力计费项 |
开通云产品及授权 |
|---|---|
SDK 安装#
您可以通过以下 pip 命令安装精调 SDK。
运行环境:python>=3.10
pip install https://ark-public-example-cn-beijing.tos-cn-beijing.volces.com/ark-sdk/ark_sdk-latest.tar.gz
版本升级#
ark upgrade
自动版本检查#
从 0.6.0 版本开始,SDK 自带升级通道。CLI 在常规命令运行前会顺手做一次"是否有新版"检查,发现落后会进行提醒提示;手动执行 ark upgrade 则会真正把新版本拉下来装上。
为避免每次都发网络请求,结果会写在 ~/.ark/upgrade_check.json,TTL 24 小时。所以如看到提示后来升级也不会被反复打扰;同样,版本更新后,本机最多隔一天才会感知到。
检查静音#
如不想被提示升级 SDK,可设置环境变量:
export ARK_SDK_DISABLE_UPGRADE_CHECK=1
配置授权信息#
您需要授权将 SDK 终端关联到指定的账号和项目。授权信息来源按以下顺序解析,前者命中就不走后者:
- CLI 命令参数(
-ak/-sk/-sts或--credential-file) - 同名环境变量
ark login已落盘的~/.ark/authorization.json鉴权结果
授权方式包括交互式登录、参数化登录以及单次 CLI 命令级授权。
ark login 交互式登录#
使用 ark login 命令开启授权过程,适用于本地开发环境的首次配置。
- 在终端工具中,使用
ark login命令开启授权过程 - 请按提示依次输入以下信息,以回车结束
- AK/SK:密钥包括 Access Key ID(简称为 AK) 和 Access Key Secret(简称为 SK),详情请参考 Access Key(密钥)管理
- Region:输入您需要访问的可用区,默认为 cn-beijing ,对应华北2(北京)
- Project:选择您的项目,默认为 default
ark login 参数化登录#
如果需要在脚本或自动化环境中完成登录,可以在 ark login 命令中通过参数传入授权信息,减少人工交互。不同环境下可用参数可能随 SDK 版本变化,建议先执行 ark login --help 查看当前版本支持的参数。
ark login --help
CLI 命令级授权#
除使用 ark login 写入默认授权信息外,您也可以在单次 CLI 命令中通过参数指定账号、项目、Region 等授权信息。该方式适用于 CI/CD、临时调试或需要在同一终端中切换多个项目的场景。
ark <verb> <noun> [arguments] [options]
创建精调任务#
项目的初始化#
您可通过ark init workspace <文件夹名> --template <模板名>命令,使用指定的template模板初始化一个具备基础结构和配置、可立即使用的精调项目,例如:
ark init workspace ark_rl_project --template rl_demo
#工作区内结构如下
#<文件名>
#├── data
#│ └── mcj_rollout_test_dataset.jsonl
#├── plugins
#│ ├── random_reward.py
#│ └── raw_rollout.py
#│ └── weather_rollout.py
#│ └── async_weather_rollout.py
#│ └── test_utils.py
#├── job.py
#├── job.yaml
#├── README.md
#├── arkworkspace.toml
#└── requirements.txt
#└── test_faas.py
目前支持的模板如下:
| template 模板名 | 简介 |
|---|---|
| rl_demo | 该模板通过强化学习,使模型精准掌握自定义函数调用天气工具的时机与方式,实现更精准流畅的天气问答功能。可按需扩展至强化学习微调场景:通过强化学习微调大型语言模型(LLM),使其通过对话(Chat)API智能结合自定义工具完成特定功能。 |
| rl_search_mcp_demo | 模板通过强化学习微调大型语言模型(LLM),优化其在深度搜索(Deep Search)场景下的性能。经训练后,模型增强了对复杂搜索意图的理解能力,可高效准确调用MCP/外部搜索API,进而生成高质量且精准的搜索结果与答案。 |
精调参数的配置#
您可以通过 Python 对象(job.py)或 YAML 文件(job.yaml)配置精调项目相关参数。两种方式使用同一套元数据字段,适用场景如下:
- Python 对象配置:适合需要在代码中动态组装参数、复用函数逻辑或结合自定义 Plugin 开发的场景。
- YAML 文件配置:适合配置相对固定、需要在 CI/CD 或命令行中复用同一份任务配置的场景。
精调项目相关参数包括:
-
必选参数:
-
customization_type:训练类型,支持 FinetuneSft / FinetuneLoRA/DPO/DPOLoRA/GRPO/GRPOLoRA/PPO -
model_reference:基础模型及其版本信息-
foundation_model: 基于模型广场模型训练
-
name: 模型名
-
model_version: 模型版本
-
-
custom_model_id: 模型仓库模型 id,与foundation_model互斥(例:custom_model_id: cm-20251019092329-rxxxv)
-
-
data:训练数据配置-
training_set: 训练集 (选择以下三种方式中的一种传入训练集)
-
local_files: 一组本地文件,单个文件大小不可超过 2GB,最多传入 20 个文件
-
tos_bucket、tos_paths: TOS桶名、TOS 对象列表(列表同时存在于一个桶内)
-
datasets: 数据集配置
-
dataset_id 数据集 id
-
dataset_version_id 数据集版本 id
-
multiplier 混入倍率
-
sample_count 混入条数,与multiplier 互斥
-
-
preset_dataset: 混入预置数据集配置,非必填
-
dataset_version_id: 预置数据集 id
-
inject_multiplier: 混入倍率,与混入样本条数互斥
-
inject_sample_count: 混入样本条数
-
-
-
max_invalid_records_ratio:数据集错误容忍百分比,与数据集错误容忍数量互斥(仅支持vlm模型的RL/GRPO训练方法配置错误容忍功能)
max_invalid_records_number:数据集错误容忍数量 -
validation_set: 验证集,非必填
- 支持 local_files / tos_bucket+tos_paths / datasets 形态的验证集,规范同上
-
validation_percentage: 切分百分之多少的训练集作为验证集,与validation_set互斥
-
-
-
可选参数:
-
custom_rl_pipeline:支持GRPOPipeline和PPOPipeline。该参数为强化学习流程配置,当训练方式为 GRPO或 PPO 时必填,详见强化学习配置。 -
enable_trajectory: 是否开启记录轨迹分析功能(仅支持对 RL 训练开启)。开启此功能后,系统自动采集训练过程各样本的数据输入输出结果,记录强化学习精调轨迹,并展示于方舟控制台轨迹分析功能下。此记录有助于模型效果分析与问题排查,对强化学习至关重要,建议训练前开启。(该功能需完成日志服务配置,需先联系管理员,前往 模型精调-TLS配置 开通) -
name:任务名称 -
project:任务所属的项目 -
hyperparameters:超参配置,超参信息查询方法见下 -
save_model_limit:保存训练产物数量上限
-
-
获取训练可用超参信息
不同模型版本支持的训练超参数存在差异,需通过ark命令行工具查询指定模型版本的超参信息。
-
命令语法:
ark get foundation-model --model <模型名> --version <模型版本> --fields hyperparameters <指定查询超参维度> -
示例命令:
ark get foundation-model --model doubao-seed-2-0-lite --version 260428 --fields hyperparameters -
示例命令执行结果:
提交精调任务#
-
通过 Python 对象完成上述配置后,可通过下面的命令提交精调任务。
python job.py -
通过 YAML 文件完成上述配置后,可通过下面的命令提交精调任务。
ark create mcj -f job.yaml
强化学习配置#
强化学习流程#
创建强化学习任务时,需配置强化学习流程custom_rl_pipeline,先选定 pipeline 类型,再按要求配置对应 plugin 函数。具体要求如下:
| 支持的 pipeline 类型 | GRPOPipeline 和PPOPipeline |
|---|---|
| rollout plugin 要求 | 仅支持填入 1 个自定义 rollout plugin,不填默认使用单轮模型推理 rollout 逻辑 |
| grader plugin 要求 | 至少需要填入一个 grader plugin,支持填写多个并分别配置权重 |
强化学习插件(plugin)#
目前支持以下自定义plugin类型:
-
Rollout plugin函数,通过
@rollout装饰器标记,支持在函数内实现自定义Rollout逻辑(如某个特定业务场景的多轮推理、多次工具调用的agent) -
Grader plugin函数,用于计算reward奖励分数,目前支持:
-
单样本评分器(single_grader),通过
@single_grader装饰器标记。针对一条轨迹独立打分。平台将同一条样本的 n_samples 拆解成多个请求分别独立打分。 -
多样本评分器 (group_grader),通过
@group_grader装饰器标记。针对一条样本的一组轨迹(不限定特定条数,一般为多条)打分,一次调用输入n_samples,返回一组得分
-
可在工作仓库任意位置实现满足规范的函数,并使用 SDK 提供的装饰器来为函数声明 plugin 相关的元信息与运行时配置。如果未填写装饰器信息,函数不能作为 plugin 函数使用。
我们提供了以下Rollout plugin函数模板和Grader plugin函数模板,您可参考签名要求和函数模板实现所需函数。
Rollout函数#
Rollout 函数主要实现 agent loop 的逻辑,函数提供 OpenAI 兼容的模型 API,用户完成 sample 过程。这个需用通过 @rollout这个装饰器来指定一些函数运行信息。
Rollout签名要求#
class RolloutResult(BaseModel):
status: str # success/failure/discard/retry
error: str
extra: Dict[str, Any]
async def demo_rollout(
context: PluginContext,
proxy: RolloutInferenceProxy,
sample: ChatCompletionSample,
) -> Optional[RolloutResult]:
入参
| 字段 | 类型 | 描述 | 样例 |
|---|---|---|---|
| context | context: PluginContext |
|
|
| proxy | RolloutInferenceProxy |
|
|
| sample | ChatCompletionSample |
输入样本 |
示例: |
返回
| 参数 | 类型 | 描述 |
|---|---|---|
| status | str |
|
| error | str | * 如果status 为 failure,可携带具体失败原因或错误栈信息,会打印到训练日志中 |
| extra | Dict[str, Any] | * 可以添加任意数据,并且会透传到自定义 reward |
Rollout函数模板#
- ChatAPI+自定义工具
基于精调 SDK 封装的 Chat API,搭配自定义工具实现业务逻辑,适合快速开发常规工具调用类场景(如天气查询、信息检索)。可参考rl_demo中 weather_rollout.py 模板。
若需更底层的控制能力,可参考
rl_demo中 raw_rollout.py 模板,手动调用proxy.update_state_from_messages和proxy.process_completion处理训练状态,实现同步化的底层逻辑控制。
- Arkitect框架+多轮推理+MCP
基于 Arkitect 框架与 MCP(Multi-Client Proxy)多客户端代理机制,适合融合多工具、复杂多轮推理的场景(如深度搜索、多步骤任务处理)。可参考rl_search_mcp_demo中draft_rollout_arkitect.py模板。
- Arkitect框架+functioncall+API调用插件
该方案结合 Arkitect 框架的 Function Call 能力与第三方 API 插件(如搜索 API),适合需要自定义 API 调用、严格参数校验的场景(如定制化搜索、第三方服务集成)。可参考rl_search_mcp_demo中 rolllout.py 模板。
Grader函数#
Grader 函数用于计算reward奖励分数,目前支持通过@single_grader装饰器标记的单样本评分器和通过@group_grader装饰器标记的多样本评分器。
Grader签名要求#
@dataclass
class RewardFunctionResult:
rewards: List[float]
metrics: Dict[str, float]
status: str # success/failure/discard/retry
error: str
def reward_fn(
context: Dict[str, Any],
sample: Dict[str, Any],
trajectories: list[Dict[str,Any]])-> RewardFunctionResult
#@group grader装饰器标记的多样本评分器为trajectories,此处以trajectories为例;
#@Single grader装饰器标记的单样本评分器为trajectory,见下方入参详细说明。
入参
| 字段 | 类型 | 描述 | 样例 |
|---|---|---|---|
| context | context: Dict[str, Any] |
|
|
| sample | Dict[str, Any] |
|
|
| trajectories | list[Dict[str,Any]] | 通过@group_grader装饰器标记的多样本评分器。
|
|
| trajectory | Dict[str,Any] | 通过@single_grader装饰器标记的单样本评分器
|
|
返回
| 参数 | 类型 | 描述 | 样例 |
|---|---|---|---|
| rewards | list[float] | 通过@group_grader装饰器标记的多样本评分器。
|
|
| reward | float | 通过@single_grader装饰器标记的单样本评分器
|
|
| metrics | Dict[str, float] |
|
|
| status | str |
|
|
| error | str | * 如果status 为 failure,可携带具体失败原因或错误栈信息,会打印到训练日志中 |
常用Grader函数#
评分器的具体实现与效果定义和业务目标紧密相关,以下是一些常用的grader实现思路:
-
比较rollout结果和样本预设的答案(通过训练集extra字段传入)
-
全等/包含判定 可参考
rl_demo中 random_reward.py -
分别调用embedding模型计算相似度进行判定
-
使用LLM进行语义比较并打分
-
-
RuleBase评分
-
输出格式判定
-
token/字符串长度惩罚
-
根据过程耗时评分
-
-
调用外部服务/插件进行判定
-
调用Code sandbox运行代码,根据是否运行成功和运行结果与预设答案匹配度打分
-
创建excel/数据库表,根据是否创建成功打分
-
将输出的SQL语句用于查询指定数据库,根据是否能执行成功和结果是否符合预期打分
-
-
通过模型对单条样本进行打分
-
LLM as a judge(基础模型 + prompt,可通过让模型在输出分值前思考并输出评分理由,提升评分准确性。同时也会增加训练服务的等待提高成本)可参考
rl_search_mcp_demo中llm_grader.py -
训练并部署GRM(可通过让模型在输出分值前思考并输出评分理由,提升评分准确性。同时也会增加训练服务的等待提高成本)
-
-
对多条样本排序赋分/综合打分
- 对一组样本进行排序的难度低于对多条轨迹分别打出准确分值。
可观测性配置#
轨迹分析#
在精调参数配置job.py文件中配置enable_trajectory=True,即可开启轨迹分析功能。开启后,系统将记录强化学习训练轨迹,可视化展示于方舟控制台模型精调的轨迹分析功能下。此记录有助于模型效果分析与问题排查,对强化学习至关重要,建议训练前开启。如需提前查看该功能效果,详见 轨迹分析 。
自定义函数日志#
根据用户自定义需求记录Rollout、Reward函数执行中的关键信息,以精准定位问题、提高排查效率。
具体实现方面,在rollout.py文件内,通过logger.info、logger.error等方法完成日志记录操作。最终,这些日志将展示于方舟控制台模型精调的自定义日志功能模块下。
(该功能需完成日志服务配置,需先联系管理员,前往 模型精调-TLS配置 开通)
自定义效果指标#
支持用户在 Grader 函数中自定义业务相关的评估指标,自定义后的指标将同步展示在方舟控制台模型精调的训练观测功能模块下,便于量化分析模型性能。
具体实现:在其metrics字段中补充自定义的键值对,将metrics与rewards、status、error一同封装至RewardFunctionResult对象中返回。
例如,可通过 NumPy 库计算奖励值的均值、标准差等统计指标并传入:
import numpy as np
# 假设已计算得到奖励值列表rewards
metrics = {
"test_mean": np.mean(rewards), # 测试奖励平均值
"test_std": np.std(rewards), # 测试奖励标准差
# 可按需添加其他自定义指标
}
Tracing#
为分析模型效果、定位问题,建议使用 Tracing 系统采集样本 rollout 每轮推理和工具调用的输入输出及耗时信息。
可选用任意 Tracing 系统,本文以ARK Tracing / cozeloop为例介绍使用方法,可参考示例调整。
ARK Tracing(推荐)
-
前置依赖
-
初始化与使用
- 对 Rollout、Grader 函数的输入输出Tracing:使用 @trace_monitor 装饰器包装 rollout、reward 函数,它基于 opentelemetry 进行数据上报,并将 trace 与轨迹关联,示例如下:
from ark_sdk.core.trace import trace_monitor #rollout 函数示例 @single_rollout( name="demo_rollout", runtime=Runtime( instance=PluginInstance.CPU4MEM8, timeout=900, max_concurrency=100 ), ) @trace_monitor def demo_rollout( context: PluginContext, proxy: RolloutInferenceProxy, sample: ChatCompletionSample, ) -> Optional[RolloutResult]: # 函数实现... #grader 函数示例 @single_grader @trace_monitor def single_random_reward_fn( context: PluginContext, sample: ChatCompletionSample, completion: ChatCompletion ) -> SingleGraderResult: # 函数实现...-
对 LLM Chat 的输入输出 Tracing:使用 wrap_inplace_trace 函数包装 LLM 客户端。示例如下:
from ark_sdk.core.trace import wrap_inplace_trace client = AsyncArk(base_url=proxy.url, api_key=proxy.jwt_token) wrap_inplace_trace(client) -
对中间过程添加自定义Tracing:使用 @observe() 装饰器记录任意函数的输入输出。示例如下:
from ark_sdk.core.trace import observe @observe() def get_current_weather(location: str, unit="摄氏度"): # 自定义中间过程函数实现
CozeLoop Tracing
-
配置与环境设置:cozeloop配置详情请参考 cozeloop SDK 使用指南。
-
本地运行配置:在终端中设置以下环境变量:
export COZELOOP_WORKSPACE_ID=xxx export COZELOOP_API_TOKEN=xxx -
训练环境配置:需在 faas 的环境变量中添加如下内容:
rollout=PipelinePluginWrapper( plugin=demo_rollout, envs={ "COZELOOP_API_TOKEN": "xxx", "COZELOOP_WORKSPACE_ID": "xxx", }, ), -
-
使用方法:
- 对Rollout函数的输入输出Tracing:使用
@coze_monitor装饰器包装 rollout 函数。该装饰器来自项目中的plugins/``coze_monitor.py文件,它基于 cozeloop 库进行数据上报,会从proxy中取出 rollout 实际的轨迹返回,并以精调任务的 ID 作为user_id(本地测试时user_id默认为test_service),方便在 cozeloop 平台上进行数据分析和筛选。示例如下:
@rollout( name="code_sandbox_grader_single_grader", description="code_sandbox_grader", runtime=Runtime( instance=PluginInstance.CPU2MEM4, timeout=900, ), ) @coze_monitor async def demo_rollout(context, proxy, sample): # 函数实现...-
对LLM Chat的输入输出Tracing:使用
wrap_inplace_trace函数包装 LLM 客户端。示例如下:client = AsyncArk(base_url=proxy.url, api_key=proxy.jwt_token) wrap_inplace_trace(client) -
对中间过程添加自定义Tracing:使用
@observe()装饰器记录任意函数的输入输出。示例如下:@observe() # type: ignore async def exec_tool_call(tool_client, name, arguments):
- 对Rollout函数的输入输出Tracing:使用
-
Cozeloop 效果:若您完成了 cozeloop 配置,运行后可在 Cozeloop 平台观测 Rollout 过程,具体效果如下:
- 分析各阶段耗时,优化rollout链路
- 指定任务,筛选 结束原因为输出超长的 模型返回
Plugin函数的测试#
为确保 Plugin 函数功能符合预期,在提交强化学习任务前,需先进行本地测试,再提交在线 FaaS 测试,最后提交训练任务。
本地测试#
在实现 rollout 函数的文件里,main 函数展示了如何在本地测试rollout函数和grader函数的结合使用。它支持用户进行单样本调试和多样本批量调试。代码如下。
- 单样本调试:测试时会基于样本,调用 demo_rollout 执行推理,获取模型的回答;将模型的回答和原始问题、正确答案一起传递给 llm_grader 进行评估,并打印评估结果。
- 多样本调试:main 函数还展示了如何使用 test_with_dataset 函数对一个数据集中的多个样本进行批量推理和评估,以获取平均奖励分数。
async def main():
from ark_sdk.core.plugin.rollout.proxy import InferenceProxy, Mode
from plugins.llm_grader import llm_grader
import os
# 调试模式,使用公共服务
mode = Mode.Inference
base_url = "https://ark.cn-beijing.volces.com/api/v3"
api_key = os.getenv("ARK_API_KEY", "xxx")
sample = ChatCompletionSample(
**{
"messages": [
{
"role": "user",
"content": "通过景栗科技的私域运营服务和与薪勤科技的产品共创,哪两个公司在各自的领域实现了用户增长或应用上架?",
}
],
"thinking": {"type": "enabled"},
"extra": {"answer": "景栗科技和薪勤科技", "prompt_id": "123"},
}
)
proxy = InferenceProxy(sample, url=base_url, jwt_token=api_key, mode=mode)
resp = await demo_rollout({}, proxy, sample)
assert resp is None or resp.status == PluginStatus.SUCCESS, (
f"rollout failed - {resp.error}"
)
logger.info(f"demo rollout done with result: {proxy.messages}")
grader_res = await llm_grader(
{},
sample,
[
Trajectory(
messages=proxy.messages,
usage=proxy.usage,
finish_reason=proxy.finish_reason,
extra=resp.extra if resp else {},
)
],
)
logger.info(f"demo grader done with result: {grader_res}")
logger.info("small dataset")
jsonl_file_path = "./data/search_dataset_dev_100.jsonl"
from plugins.test_utils import test_with_dataset
# NOTE: 可以针对其他模型测试数据集的reward分数,或者构建SFT数据集进行冷启动。正式提交任务前请使用此方法测试整体流程的并发能力,max_concurrent=batch_size,保证训练运行效率
rewards = await test_with_dataset(
jsonl_file_path,
demo_rollout,
llm_grader,
api_key,
base_url=base_url,
limit=100,
max_concurrent=16,
n_sample=1,
top_p=1,
temperature=1.0,
)
logger.info(f"avg rewards: {sum(rewards) / len(rewards)}")
在线FaaS测试#
完成本地测试后,用户可采用 SDK 或 CLI 方式拉起在线运行环境对plugin函数进行测试。需先完成 requirements.txt 的更新,具体要求及测试方法如下:
-
更新requirements.txt:为避免 FaaS 环境装包时依赖自动升级引发异常,按以下规则生成
requirements.txt:- 本地环境验证通过后,推荐使用 uv 管理环境,执行
uv pip freeze > requirements.txt固定间接依赖版本,过滤冗余依赖,精简依赖列表。
- 本地环境验证通过后,推荐使用 uv 管理环境,执行
-
SDK方式用法
运行demo中test_faas.py文件,具体代码如下:
from ark_sdk.resources.pipeline_plugin.test_instance import (
get_or_create_pipeline_plugin_test_instance,
)
from ark_sdk.types.pipeline_plugin.rollout import (
ChatCompletionSample,
)
from plugins.rollout import demo_rollout
from ark_sdk.core.plugin.rollout.proxy import InferenceProxy, Mode
if __name__ == "__main__":
instance = get_or_create_pipeline_plugin_test_instance(demo_rollout)
base_url = "https://ark.cn-beijing.volces.com/api/v3"
api_key = "your_apikey"
sample = ChatCompletionSample(
**{
"messages": [
{
"role": "user",
"content": "北京天气",
}
],
"extra": {},
}
)
proxy = InferenceProxy(sample, url=base_url, jwt_token=api_key, mode=Mode.Inference)
resp = instance.request(
{
"context": {},
"proxy": proxy,
"sample": sample,
},
# sync 为false时不会创建新的faas函数(不会更新代码)
sync=False,
)
print(resp)
- CLI方式用法
通过 ark test pipeline_plugin 命令,快速测试强化学习精调的自定义 Plugin 函数。
-
命令语法
ark test pipeline_plugin --fn <函数标识> --request <JSON请求体> [--sync] -
关键参数
| 参数 | 必填 | 说明 |
|---|---|---|
| --fn | 是 | 函数唯一标识,例:plugin.code_agent_grader:grader |
| --request | 是 | JSON 格式请求体,具体样例可参考SDK用法。 |
| --sync | 否 | 默认值为否,用于确定在执行前是否触发一次同步。 |
-
完整示例
ark test pipeline_plugin --fn plugin.code_agent_grader:grader --request '{"sample":{...},"completion":{....}}' --sync
提交调试任务#
此功能需要使用 0.2.16 或更高版本的 SDK。
您可以提交一个调试任务,在不排队等待 GPU 资源的情况下,对数据和 plugin 进行端到端校验。在 rollout 过程中,该任务将请求您指定的 endpoint 来执行推理。
要提交调试任务,请在 ModelCustomizationJob 对象中设置 debug_config(包含 endpoint_id 和 apikey),并在调用 submit 函数时将 debug 参数设为 True。
通过 Python 脚本提交
if __name__ == "__main__":
mcj = ModelCustomizationJob(
name="test-mcj",
data=Data(
training_set=TrainingDataset(local_files=["tests/e2e/data/grpo_naive.jsonl"])
),
model_reference=ModelReference(
foundation_model=FoundationModelReference(
name="doubao-seed-2-0-lite", model_version="260428"
)
),
custom_rl_pipeline=GRPOPipeline(
rollout=demo_rollout,
graders=[random_reward],
),
debug_config=ModelCustomizationJobRLDebugConfig(
apikey="your_api_key",
endpoint_id="endpoint_id", # ep 对应模型无需和训练模型属于同一模型
)
)
mcj.submit(debug=True) # 设为 true 才会提交调试任务,否则仍是正式训练任务
print(mcj.url)
通过 YAML 提交
name: sdk-job
customization_type: GRPO
model_reference:
foundation_model:
name: doubao-seed-2-0-lite
model_version: '260428'
custom_rl_pipeline:
graders:
- plugin:
name: random_reward
python_func: plugins.random_reward:random_reward_fn
envs:
foo: bar
weight: 0.5
rollout:
plugin:
name: demo_rollout
python_func: plugins.weather_rollout:demo_rollout
envs:
foo: bar
data: # 数据配置
training_set:
local_files:
- ./data/mcj_rollout_test_dataset.jsonl # 训练集本地文件路径
save_model_limit: 1 # 保存模型的数量限制
debug_config:
apikey: your_api_key
endpoint_id: endpoint_id
执行以下命令可以完成 YAML 提交调试任务。
ark create mcj --file job.yaml --debug
提交强化学习任务#
完成 plugin 函数编写、测试和调试任务验证后,即可提交正式的强化学习训练任务。提交方式与普通精调任务一致,通过 Python 对象或 YAML 文件配置 custom_rl_pipeline 后执行提交命令。
-
通过 Python 对象提交:
python job.py -
通过 YAML 文件提交:
ark create mcj -f job.yaml
提交后,任务将进入排队调度阶段,您可通过控制台或 CLI 查看任务状态和训练进度。
使用资源组提交任务#
如果您的账号或项目已经配置了专用资源组,可以在创建任务时指定资源组,让训练任务调度到对应资源池。资源组适用于资源隔离、稳定性保障或高优任务等场景。
使用资源组前,请确认:
- 目标资源组已经开通并授权给当前账号或项目。
- 当前精调任务的模型、训练方式和资源组能力匹配。
- 资源组参数名称和取值以当前 SDK / CLI 版本为准,可通过
ark create mcj --help或 SDK 类型定义查看。
查看并管理精调任务#
创建精调任务后,您可以通过控制台和 CLI 命令行两种方式查看和管理精调任务。
控制台#
您可以访问 控制台 进行界面化操作,查看任务状态、训练进度和日志等信息。
CLI 方式#
CLI命令整体使用格式为 ark [verb] [noun] [arguments] [options] ,常用任务管理命令说明如下表所示。
| 功能描述 | 命令语法 | 关键参数 / 选项 | 说明 |
|---|---|---|---|
| 查看所有精调任务 | ark list mcj [选项] | --page-size/-ps:单页返回数量,默认为 10--page-number/-pn:查询页数,默认为 1--customization_type/-t:限制查询的任务训练方式,多个训练方式逗号分隔,默认不限制--phase/-p:限制查询的任务的阶段,多个训练方式逗号分隔,默认不限制 |
列举账号下的精调信息,包括精调任务ID,名称,训练方式,基础模型,现处阶段等。 |
| 获取单个任务详情 | ark get mcj <任务ID> | 任务ID:可通过 控制台 或查看所有精调任务命令获取 | 可获取精调任务详情:包括基任务的身份标识、当前状态、使用和生成模型信息、超参数、数据集位置、控制台链接 : 在网页上查看此任务的快捷入口。 |
| 拉取任务配置至本地 | ark pull mcj <任务ID> [选项] | --include-data/--exclude-data:用于选择是否拉取数据,默认不拉取数据。--include-plugin/--exclude-plugin:用于选择是否拉取plugin代码,默认拉取。 |
本地修改后重新提交将生成新任务,不影响原任务。 |
常用命令示例如下:
# 1. 查看单页20条、第2页的RL类型精调任务
ark list mcj -ps 20 -pn 2 -t RL
# 2. 查询指定ID的任务详情
ark get mcj mcj-xxxxxx-xxx
# 3. 拉取任务配置、数据集及Plugin代码至本地
ark pull mcj mcj-xxxxxx-xxxxx --include-data --include-plugin
精调产物使用与管理#
精调任务完成后,会生成自定义模型产物。您可以对这些产物进行查看、部署、量化、上传等操作。更多详情请参阅 管理自定义模型。
控制台#
您可以在 控制台 的模型管理页面查看和管理精调产物。
CLI 方式#
常用产物管理命令如下:
- 查看全部产物
ark list cm
- 上传模型
# 上传qwen模型
ark create um -n $name -fmv qwen3-0-6b/20250429 -q BF16 -tb $TOS_BUCKET -tp $TOS_PREFIX
- 量化模型
# 创建W8A8精度模型
ark create qm -id cm-import-20260202164216-bs9bx -q W8A8_FP8
- 查看指定产物的量化模型
ark list qm -id $cm_id
Advanced Feature#
以下能力用于定制强化学习的数据采样、优势值计算、蒸馏和训练稳定性。使用前请先升级到最新版本 SDK,并通过本文开头的模型支持表和 ark get foundation-model 查询目标模型、训练方式及超参数是否支持对应能力。
Group Rollout#
Group Rollout 用于需要在同一组样本或同一组候选输出之间共享上下文、统一采样或统一计算中间结果的强化学习场景。相比逐条样本独立执行 rollout,Group Rollout 可以帮助您在插件函数中按组处理样本,减少重复计算,并为组内相对比较类任务提供更自然的实现方式。
普通 Single Rollout 会针对同一个 sample 并行执行 num_generations 次,各条 trajectory 互相不可见。Group Rollout 则只调用一次 plugin,并在同一次调用中生成 n_sample 条 trajectory,因此各分支可以共享中间状态或互相比较。
| 对比项 | Single Rollout | Group Rollout |
|---|---|---|
| 装饰器 | @single_rollout(旧的 @rollout 仍兼容) |
@group_rollout |
| 执行粒度 | 一次调用生成一条 trajectory | 一次调用生成一组 trajectory |
| 分支感知 | 各 trajectory 相互独立 | 同组 trajectory 可以共享状态 |
| 返回类型 | RolloutResult |
GroupRolloutResult |
| 对话接口 | Chat API 或 Responses API | 必须使用 Responses API |
函数签名#
Group Rollout 的函数签名需要增加 n_sample 参数。n_sample 等于任务中的 num_generations,由训练引擎传入。
@group_rollout(
name="group_rollout",
runtime=Runtime(
instance=PluginInstance.CPU4MEM8,
max_concurrency=100,
min_replicas=1,
max_replicas=10,
timeout=900,
),
)
async def group_rollout(
context: PluginContext,
proxy: RolloutInferenceProxy,
sample: ChatCompletionSample,
n_sample: int = 1,
) -> GroupRolloutResult:
...
proxy.rollout_client() 和 proxy.async_rollout_client() 会根据装饰器自动返回适用于 Single Rollout 或 Group Rollout 的客户端。只有直接调用底层包装函数时,才需要区分:
- Single Rollout:
wrap_client_inplace/wrap_async_client_inplace。 - Group Rollout:
wrap_responses_client_inplace/wrap_responses_async_client_inplace。
返回结构#
class SingleResponse(BaseModel):
id: str
extra: Optional[Dict] = None
class GroupRolloutResult(BaseModel):
status: PluginStatus = PluginStatus.SUCCESS
error: Optional[str] = None
responses: List[SingleResponse] = []
一个 GroupRolloutResult 中的所有 trajectory 共享 status 和 error。如果整个 group 返回 PluginStatus.DISCARD,训练引擎会丢弃这一组样本。返回时还需满足:
responses中每个id对应一条以该 response 为最后一轮的完整 trajectory。len(responses)必须等于n_sample,SDK 会在提交或运行时校验。SingleResponse.extra会透传给 Grader plugin,可用于携带预计算奖励或业务元数据。
return GroupRolloutResult(
status=PluginStatus.SUCCESS,
responses=[
SingleResponse(id=response_1.id),
SingleResponse(id=response_2.id),
SingleResponse(id=response_3.id, extra={"reward": 1.0}),
],
)
使用 Responses API 构造分支对话#
Group Rollout 必须使用 Responses API。多轮对话时只需传入本轮新增的 input,并通过 previous_response_id 指定父节点。SDK 会在客户端维护上下文,不需要手动拼接完整 messages。
client = proxy.async_rollout_client()
response_1 = await client.responses.create(
model="doubao-seed-2-0-lite-260428",
input=[{"role": "user", "content": "人之初"}],
)
response_2 = await client.responses.create(
model="doubao-seed-2-0-lite-260428",
input=[{"role": "user", "content": "性相近"}],
previous_response_id=response_1.id,
)
response_3 = await client.responses.create(
model="doubao-seed-2-0-lite-260428",
input=[{"role": "user", "content": "苟不教"}],
previous_response_id=response_1.id,
)
return GroupRolloutResult(
status=PluginStatus.SUCCESS,
responses=[
SingleResponse(id=response_1.id),
SingleResponse(id=response_2.id),
SingleResponse(id=response_3.id),
],
)
Responses API 的 function tool 结构不需要 Chat API 中的 function 嵌套层:
[
{
"type": "function",
"name": "get_current_weather",
"description": "获取指定地点的天气信息",
"parameters": {"type": "object", "properties": {}}
}
]
如果需要插入外部模型生成且不参与训练的消息,可调用 proxy.update_state_from_messages()。该方法只接收增量消息,并返回可继续分支对话或直接放入结果的 response ID。
new_id = proxy.update_state_from_messages(
messages=[
{"role": "user", "content": "子不教"},
{"role": "assistant", "content": "父之过"},
],
previous_response_id=response_3.id,
)
Custom Advantages#
在 GRPO 训练中,Custom Advantages 支持您在每条 trajectory 中自定义 token level(或 sequence level)的 advantages,并返回给训练引擎,从而在优势估计环节引入业务侧的定制化逻辑。
标准 GRPO 会先对同组 reward 做归一化,得到 sequence level advantage,再广播到各 token,并乘以 loss mask 屏蔽不参与训练的 token。
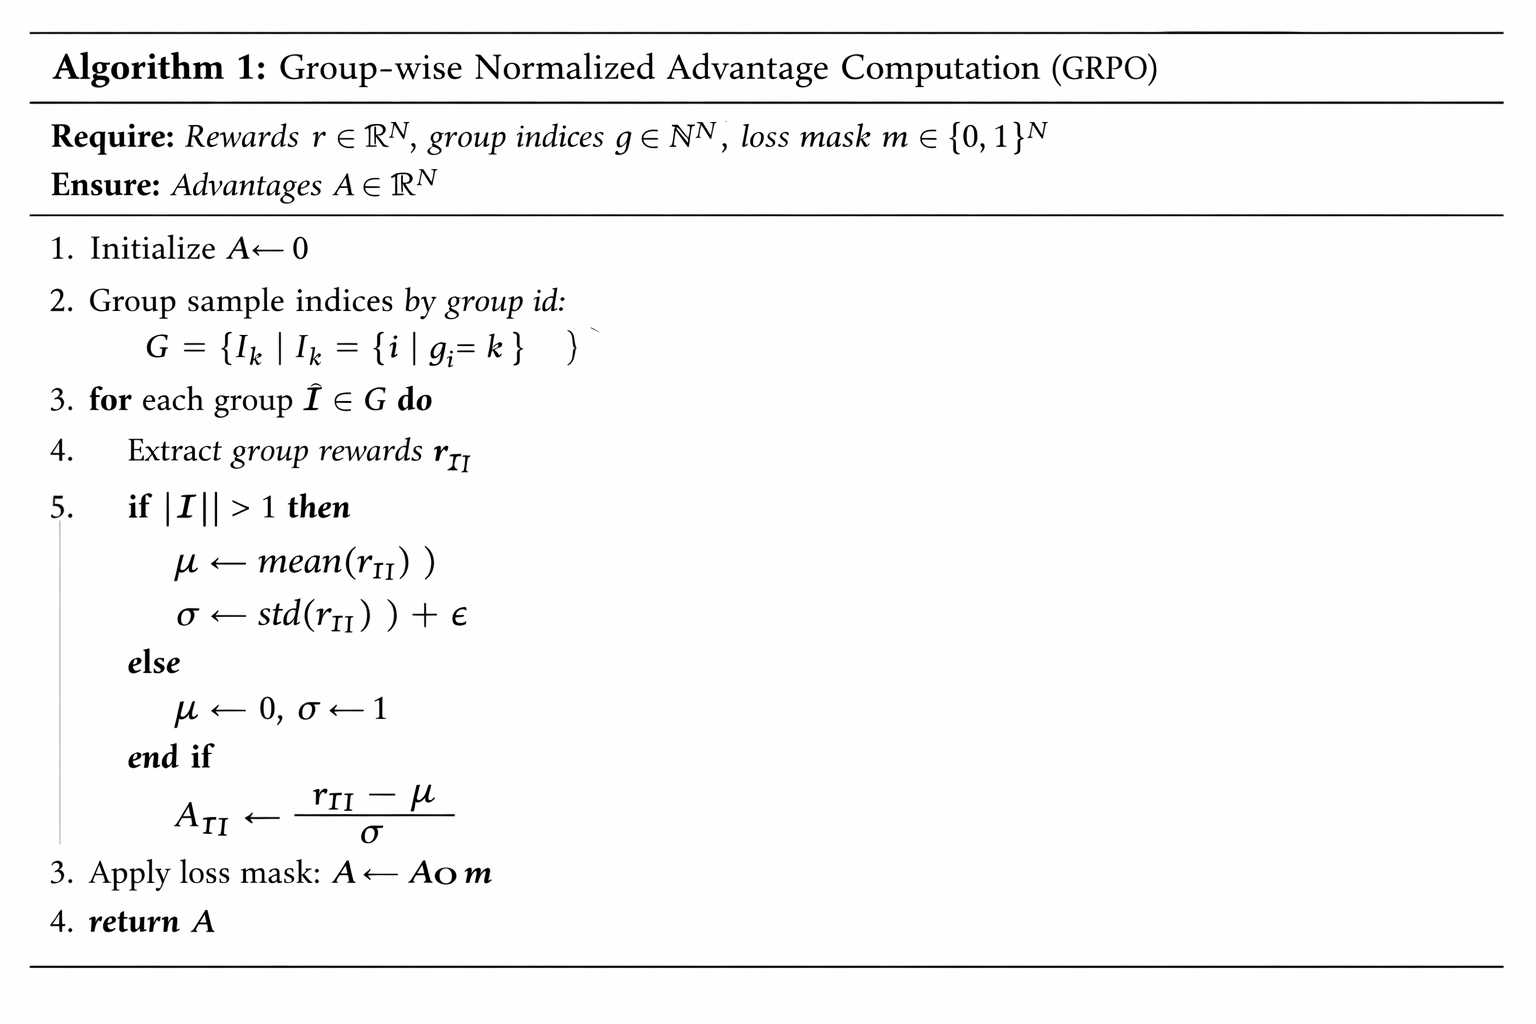
Custom Advantages 允许 Grader plugin 直接返回自定义的 sequence level 或 token level advantages。默认不返回这两个字段时,训练引擎继续使用标准算法,不影响已有任务。
class GroupGraderResult(BaseModel):
rewards: List[float]
metrics: Dict[str, float]
status: PluginStatus
error: str
seq_advantages: Optional[List[float]] = None
tok_advantages: Optional[List[List[float]]] = None
Sequence level advantages#
seq_advantages 中的每个元素对应一条 trajectory,列表长度必须与 trajectories 相同。下面的示例复现标准 GRPO 的组内 reward 归一化逻辑。
def custom_advantage_grader(
context: PluginContext,
sample: ChatCompletionSample,
trajectories: List[Trajectory],
) -> GroupGraderResult:
rewards = [
trajectory.extra["reward"]
if trajectory.extra and "reward" in trajectory.extra
else 0.0
for trajectory in trajectories
]
import math
count = len(rewards)
if count > 1:
reward_mean = sum(rewards) / count
variance = sum(
(reward - reward_mean) ** 2 for reward in rewards
) / (count - 1)
reward_std = math.sqrt(variance) + 1e-6
else:
reward_mean = 0.0
reward_std = 1.0
seq_advantages = [
(reward - reward_mean) / reward_std for reward in rewards
]
return GroupGraderResult(
rewards=rewards,
status=PluginStatus.SUCCESS,
error="",
metrics={},
seq_advantages=seq_advantages,
)
Token level advantages#
使用 token level advantages 时,可以从 Trajectory 获取以下 token 信息:
class Trajectory:
total_loss_weight: Optional[List[float]] = None
total_token_ids: Optional[List[int]] = None
total_token_logprobs: Optional[List[float]] = None
total_token_ids 覆盖从 sample 开始到最后一轮对话结束的所有 token。total_loss_weight 和 total_token_logprobs 与其逐项对齐。total_loss_weight 中的有效值对应由 policy model 生成、参与训练的 assistant token;用户消息、外部拼接消息和其他不参与训练的部分会被 mask。
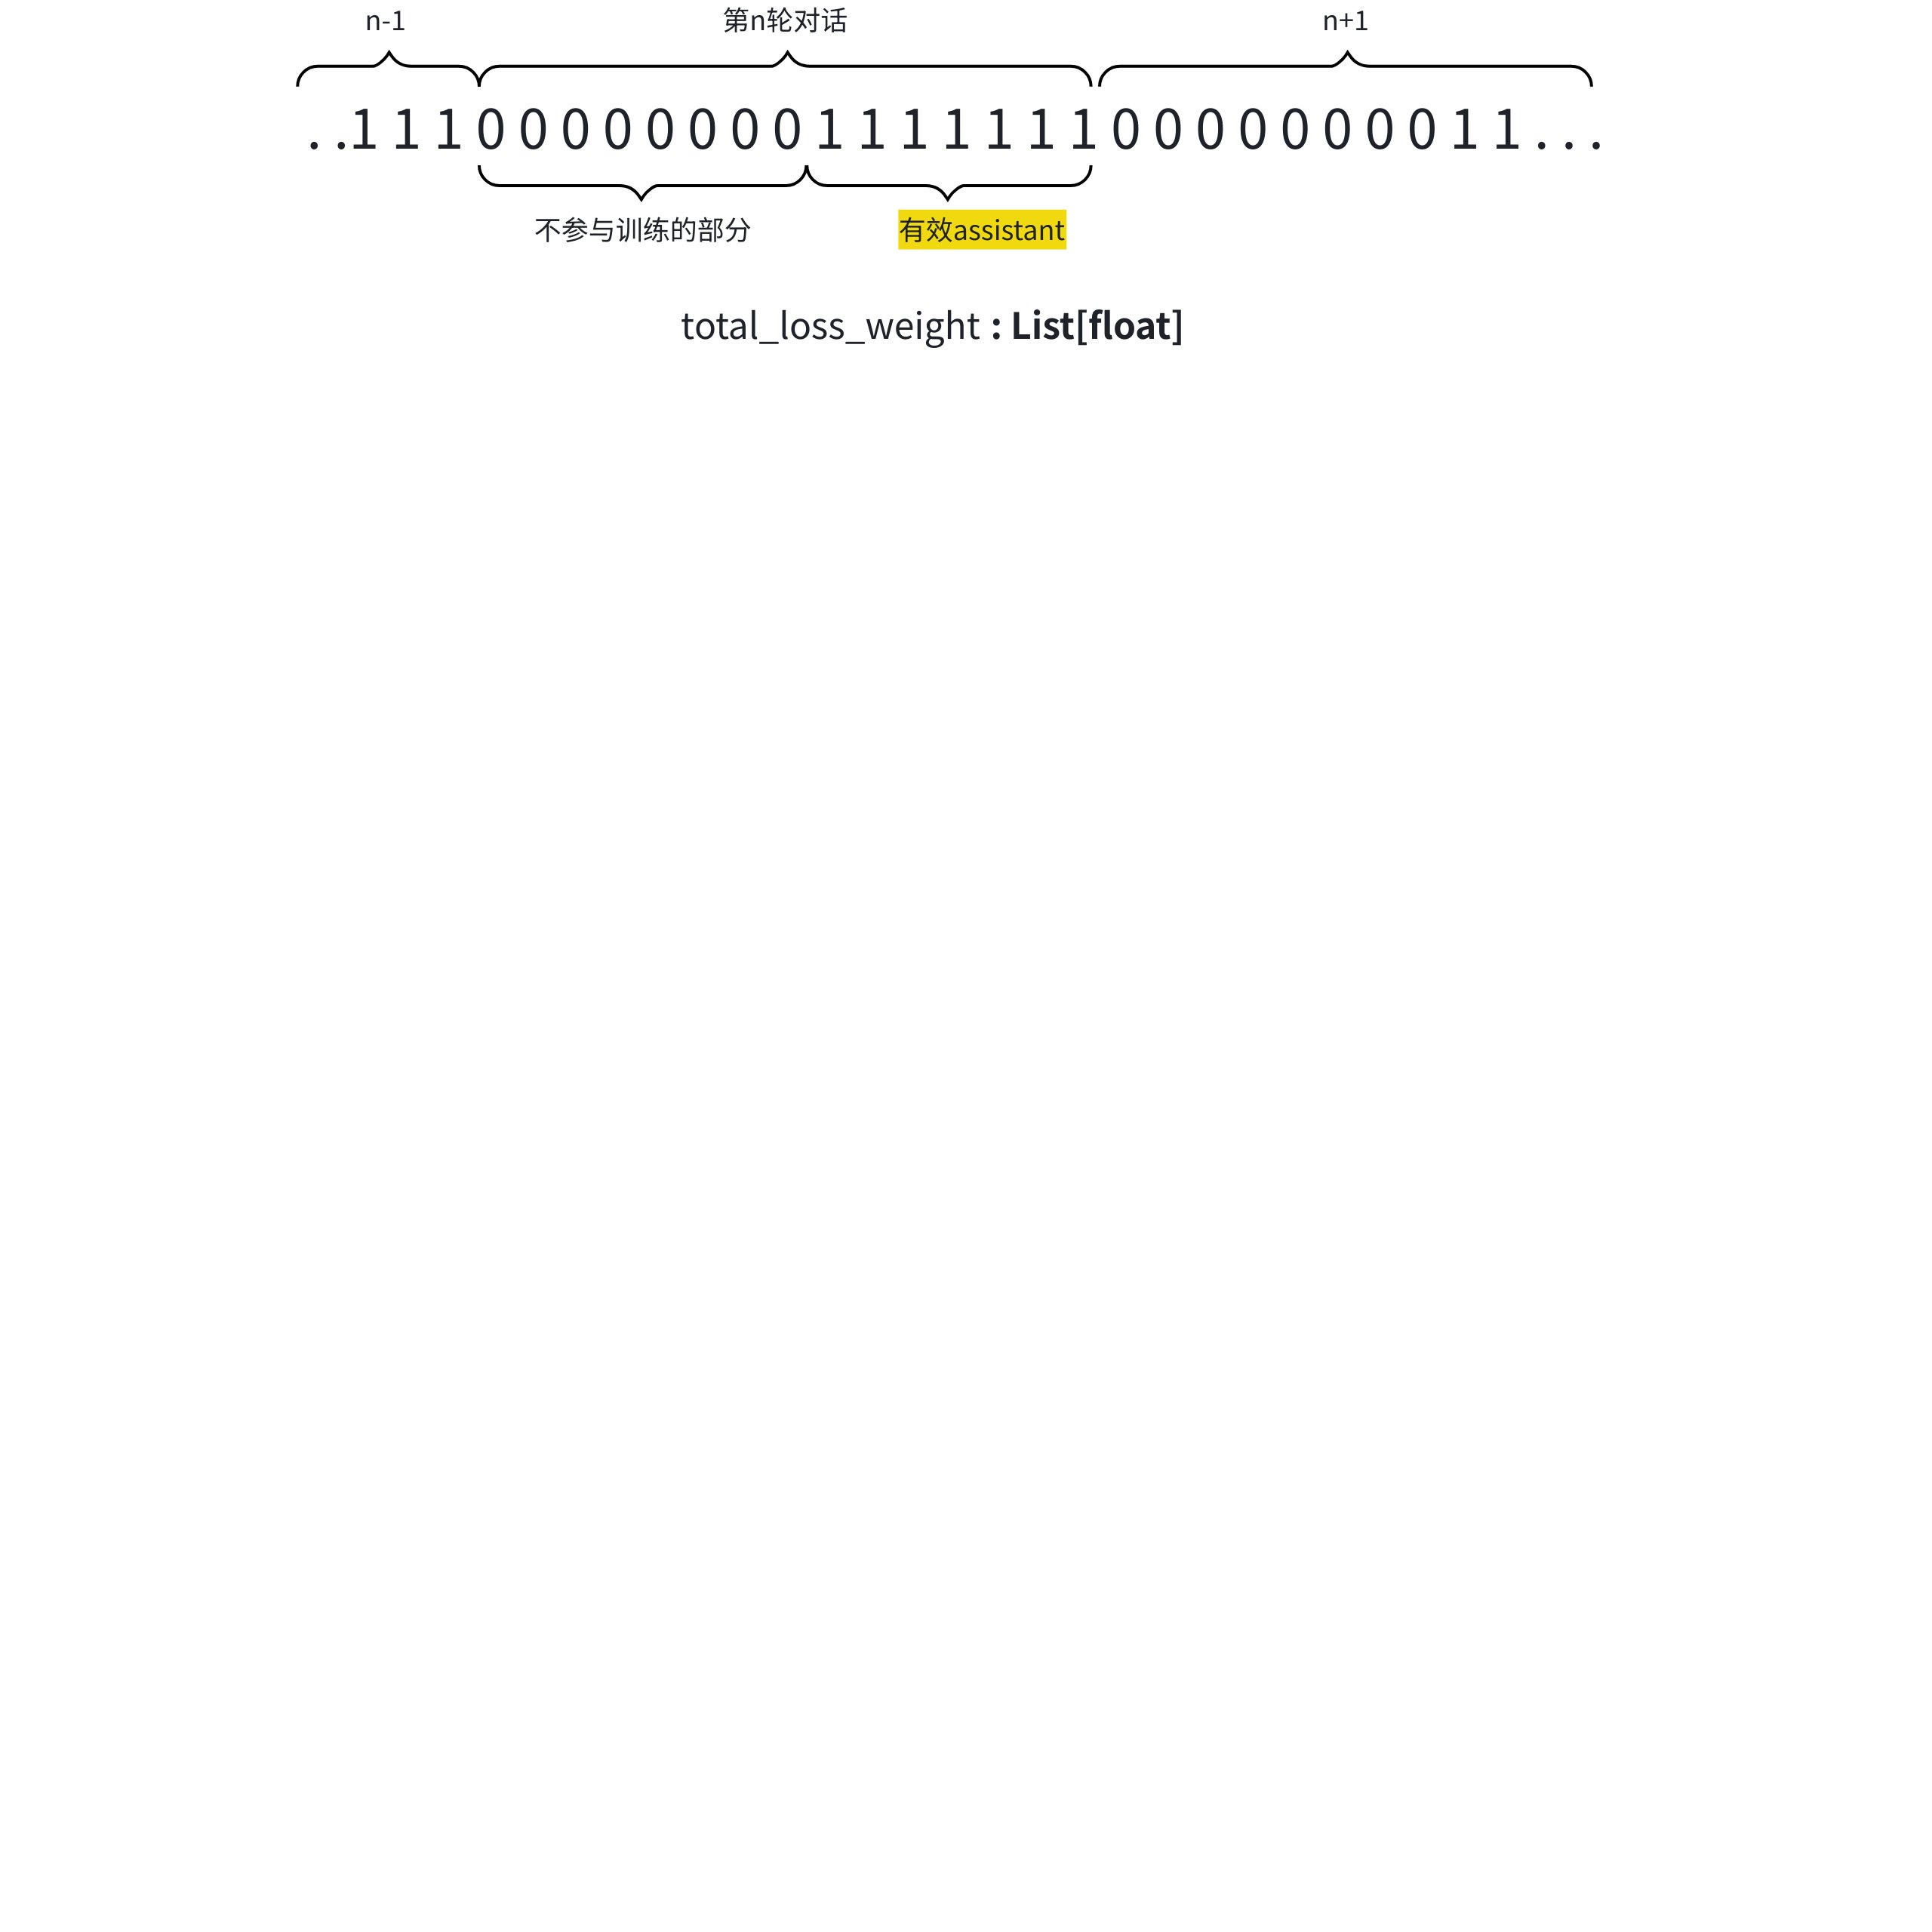
返回 tok_advantages 时,外层列表需与 trajectories 一一对应,内层列表长度需与该 trajectory 的 total_token_ids、total_loss_weight 和 total_token_logprobs 一致。不参与训练的位置可以填占位值,训练引擎仍会再次应用 mask。
tok_advantages = []
for index, trajectory in enumerate(trajectories):
assert trajectory.total_loss_weight is not None
token_count = len(trajectory.total_loss_weight)
token_values = [
seq_advantages[index] for _ in range(token_count)
]
tok_advantages.append(token_values)
return GroupGraderResult(
rewards=rewards,
status=PluginStatus.SUCCESS,
error="",
metrics={},
tok_advantages=tok_advantages,
)
配置约束#
- 同一次 Grader plugin 调用不能同时返回
seq_advantages和tok_advantages。 - 同一个 batch 不能只有部分样本启用 Custom Advantages、其余样本返回
None。 - 在满足前两项约束时,同一个 batch 中可以同时存在 sequence level 和 token level advantages,训练引擎会统一展开到 token level。
- 对返回值执行长度、数值范围及
NaN/Inf校验,避免异常值影响训练稳定性。
感知训练步数#
Rollout 和 Grader plugin 可以通过 PluginContext.current_training_step 获取当前训练步数。该值与轨迹分析中显示的 step 一致,可用于按训练阶段调整 reward 或 advantages。
class PluginContext(BaseModel):
model_customization_job_id: str = ""
foundation_model_name: str = ""
foundation_model_version: str = ""
customization_type: str = ""
phase: str = ""
is_mock: bool = False
current_training_step: Optional[int] = None
OPD 蒸馏#
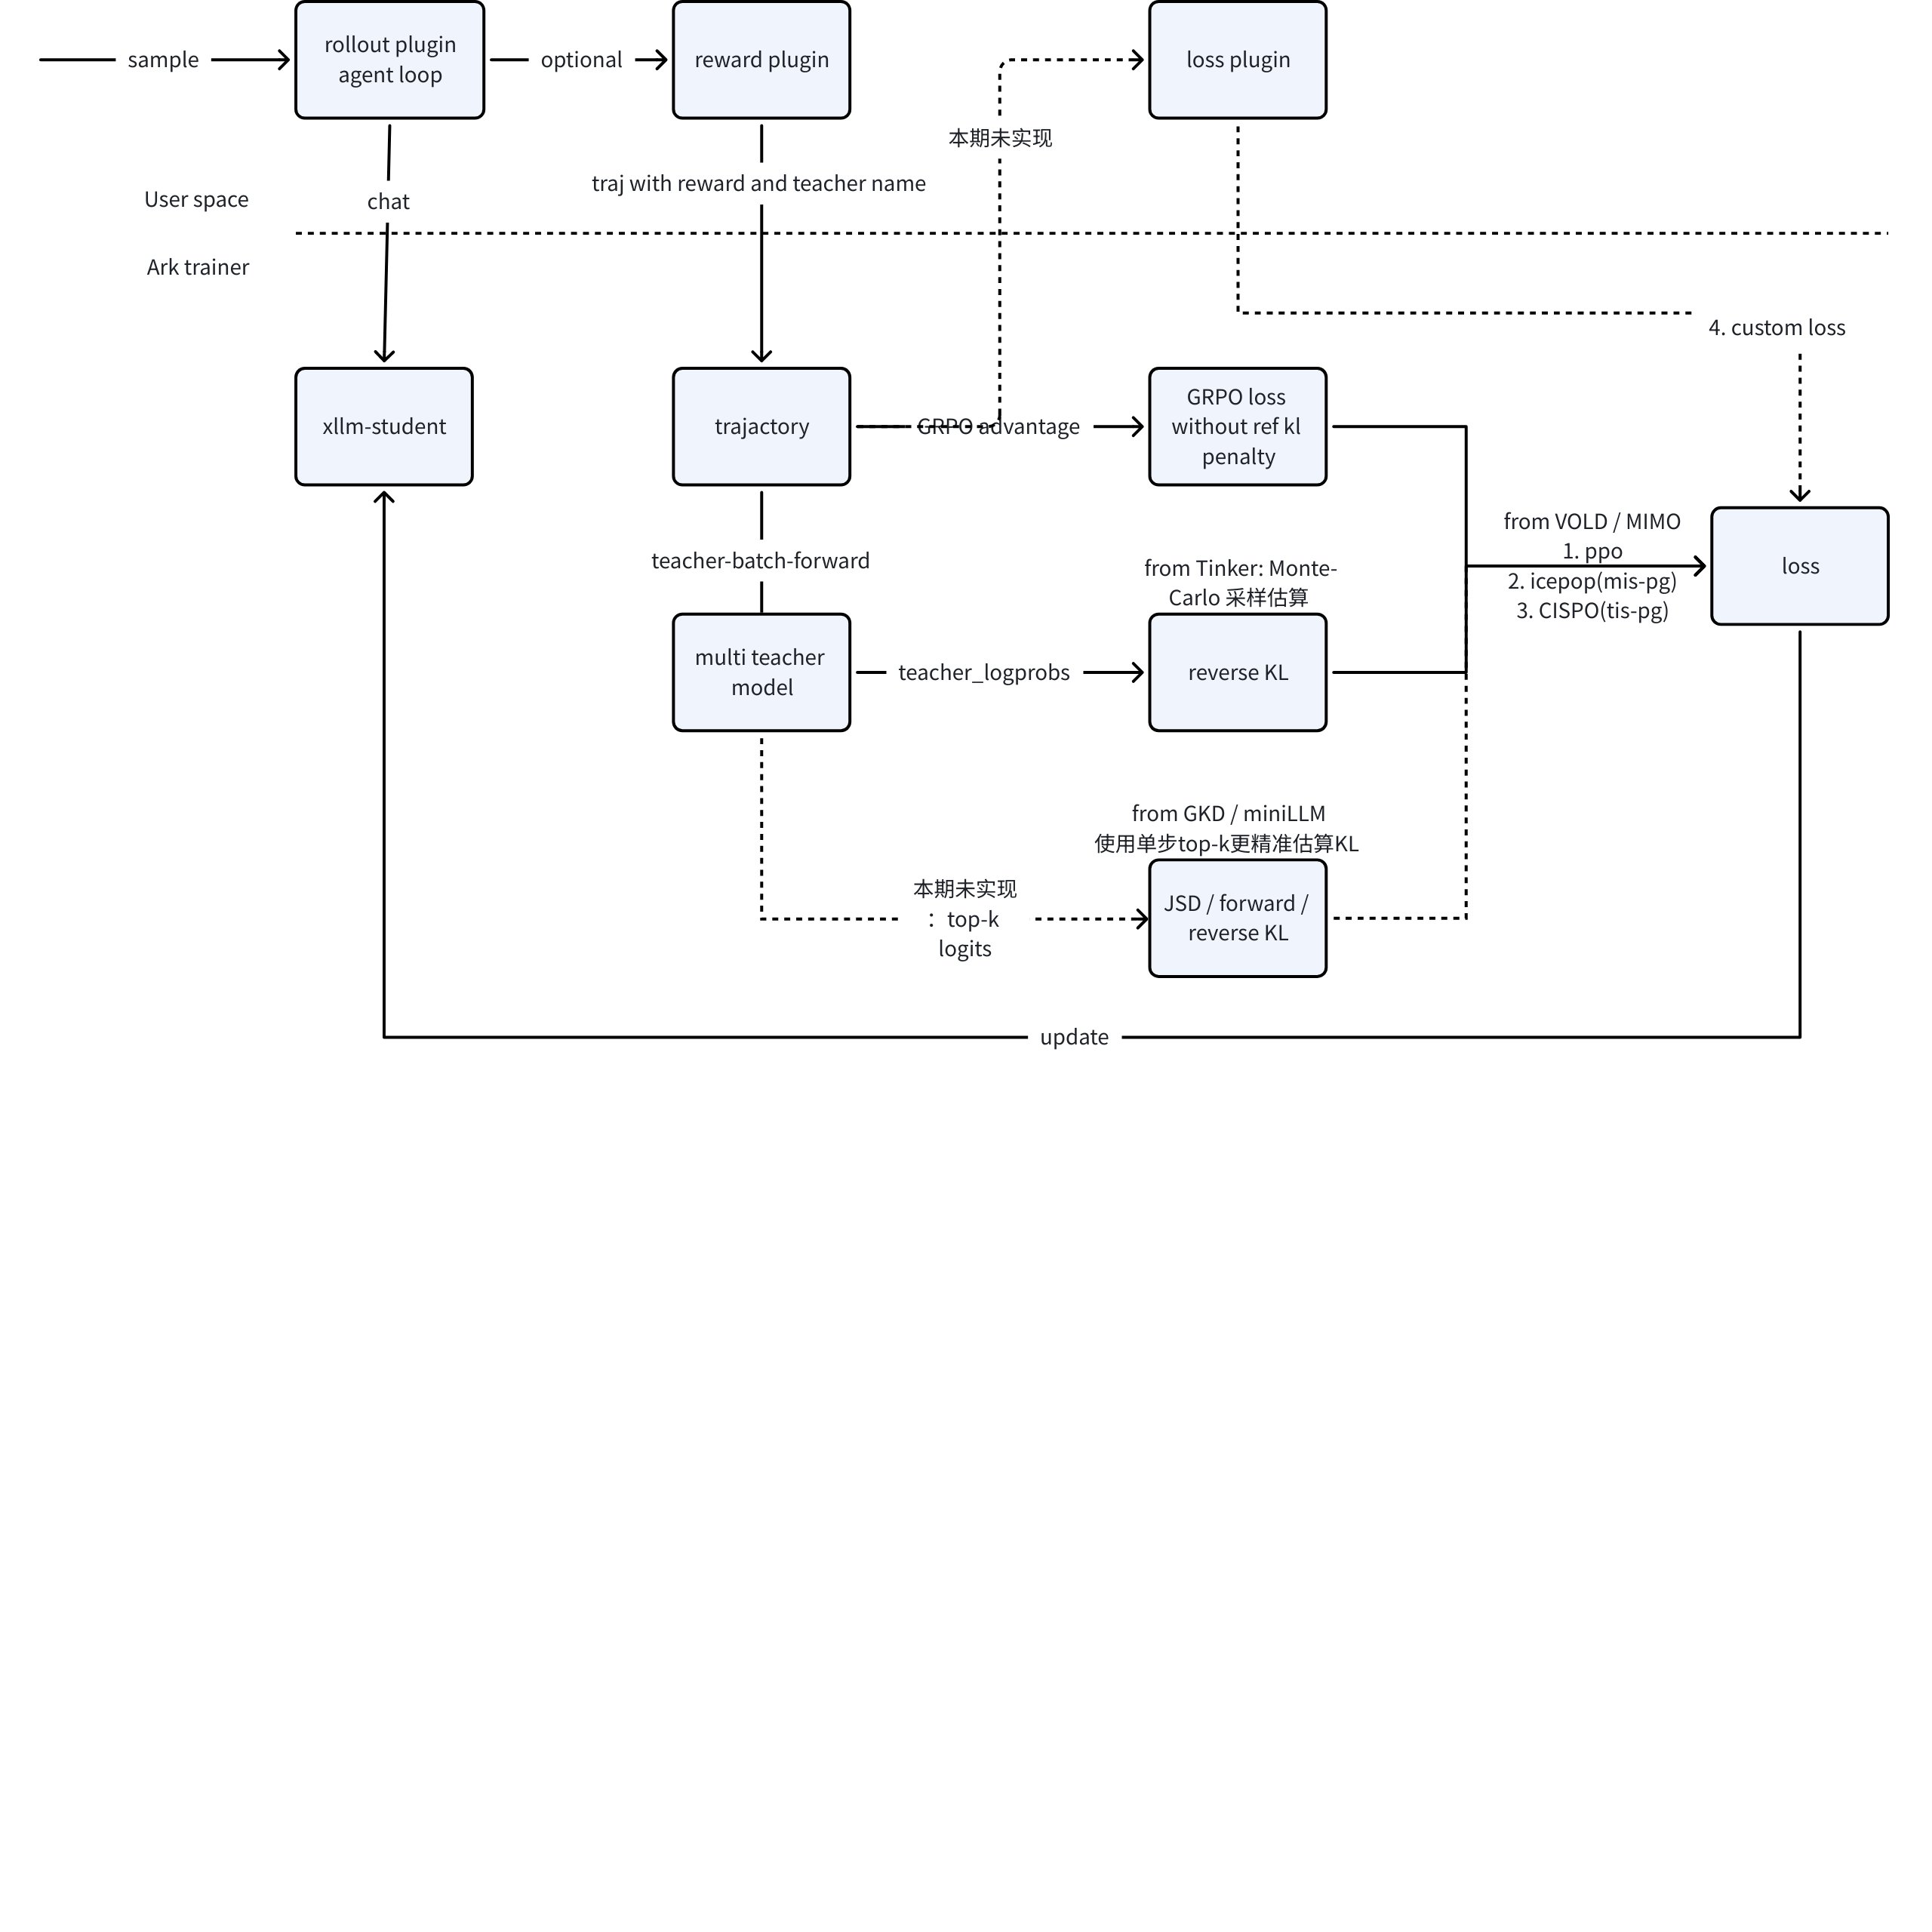
OPD(On-Policy Distillation)蒸馏支持在强化学习流程中结合在线蒸馏,通过教师模型在策略采样过程中提供监督信号,帮助学生模型在保持策略一致性的同时提升训练效率与效果。
OPD 适用于同系列模型之间的白盒蒸馏,支持:
- 为不同 trajectory 动态选择 teacher,实现 Multi-Teacher Routing。
- 同时组合 task reward(GRPO、GAE 或 Custom Advantages)与 OPD 信号。
- 为 teacher 配置与 student 不同的 context,例如 rubric、人工示范轨迹或参考步骤。
跨系列模型和黑盒蒸馏暂不支持。具体 student/teacher 组合、训练方式和开白范围以模型支持表及控制台为准。
配置 Teacher#
在 Rollout plugin 的结果中写入本条 trajectory 使用的 teacher 名称:
return RolloutResult(
status=PluginStatus.SUCCESS,
config={
"teachers": {
"teacher_math": {},
}
},
)
在 job.py 的 OPD pipeline 中为同名 teacher 配置模型:
teachers = {
"teacher_math": TeacherConfig(
model=ModelReference(
foundation_model=FoundationModelReference(
name="doubao-seed-2-0-mini",
model_version="260428",
)
)
)
}
pipeline = OPDPipeline(
rollout=demo_rollout,
graders=[task_reward],
teachers=teachers,
)
当前一条 trajectory 只能指定一个 teacher;如需多 teacher,可为不同 trajectory 分配不同 teacher。
Advantage 与 Loss#
OPD 将 task advantage 和 student/teacher 的概率差异组合为训练信号:
OPD Advantage =
task_reward_coef * task_advantage
- kl_reward_coef * (student_logprob - teacher_logprob)
支持以下策略梯度 Loss:
| Loss | 说明 | 建议场景 |
|---|---|---|
ppo_is |
标准 PPO clipped objective | 需要保持标准 PPO 目标时使用 |
mis_pg |
对 importance ratio 截断后直接作为策略梯度权重,越界 token 梯度为 0 | 默认推荐;建议 clip_ratio_high=0.5、clip_ratio_low=0.5 |
tis_pg |
将截断后的 importance ratio detach,再加权 log probability | 需要 Truncated IS-PG / CISPO 语义时使用 |
建议将 loss_agg_mode 设为 token-mean。具体可用 Loss 和超参数范围以 ark get foundation-model 的查询结果为准。
配置 Teacher context#
Teacher context 只对 teacher 可见,可用于提供 rubric、参考步骤或人工示范,不会写入 student 的可见上下文。qa_index 从 0 开始,按 policy model 生成的 assistant 轮次计数。
return RolloutResult(
status=PluginStatus.SUCCESS,
config={
"teachers": {
"teacher_math": {
"teacher_context": [
TeacherContext(
qa_index=0,
message=ChatCompletionMessage(
role="user",
content="以下是参考步骤:...",
),
).model_dump(exclude_none=True)
]
}
}
},
)
使用时需注意:
teacher_context为列表,长度不能超过总对话轮次。- 多轮场景下,teacher 会看到历史轮次已配置的 context。
- context 内容当前使用文本消息;不要传入图片或 list 结构 content。
- 提交任务前先在本地验证新增 context 后的 teacher 行为符合预期。
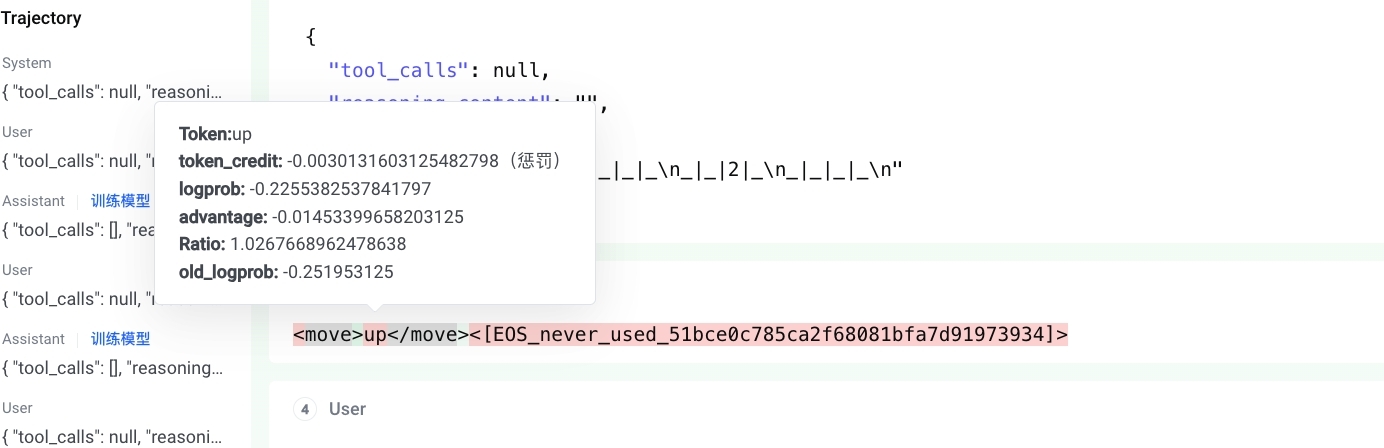
Token 观测#
开启轨迹分析后,可以在 Sample & Trajectory 页签显示 Token credit 分布,并筛选 clipped token。
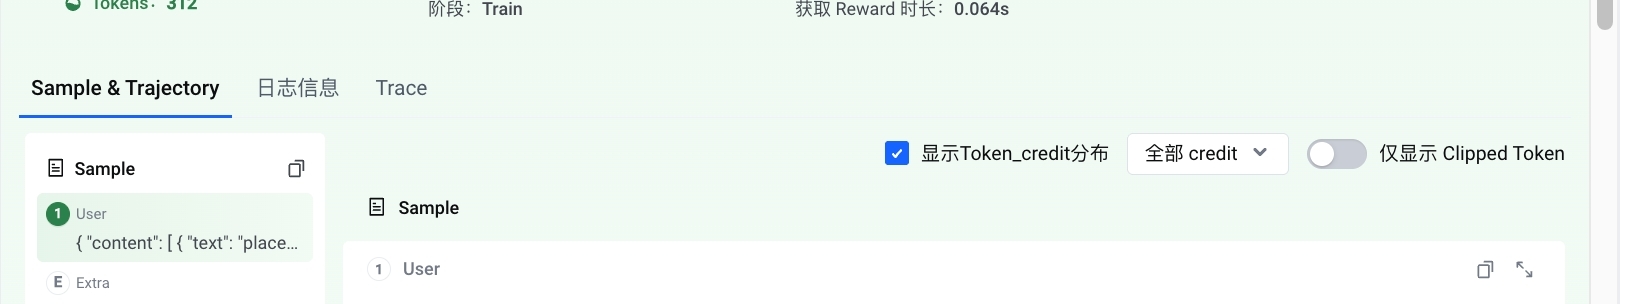
选中 token 后,可以查看 token_credit、logprob、advantage、ratio 和 old_logprob 等明细,用于定位 teacher 信号、截断和策略更新问题。
Top-k 蒸馏#
通过以下命令查询目标模型当前支持的 OPD 超参数:
ark get foundation-model --model doubao-seed-2-0-lite --version 260428 --fields hyperparameters
| 参数 | 说明 | 取值 |
|---|---|---|
topk |
OPD 蒸馏使用的 top-k token 数;topk <= 1 使用 sampled-token reward shaping,topk >= 2 启用 top-k distillation |
[0, 128] |
reverse_kl_weight |
top-k distillation 中反向 KL 的混合权重;0 为 forward KL,1 为 reverse KL |
[0, 1] |
topk_type |
top-k token 集合来源 | default、student、teacher |
normalize_topk |
是否对 top-k token 子分布重新归一化 | true、false |
Routing replay#
MoE 模型在 rollout、actor forward(重新计算 old logprobs)和 actor update 三个阶段会分别执行 expert routing。如果三次 routing 结果不一致,训练时使用的 log probability 就会偏离实际采样策略,形成 off-policy 偏移。Routing replay(R3)会记录 rollout 阶段的 expert routing,并在后续计算中复用,从而降低 logprobs diff、提升训练稳定性。
单轮语义#
Routing 记录的是每次 forward input position 的 expert assignment,不是最终序列中每个输出 token 的 assignment。对于包含 n_input 个 prompt token 和 n_decode 个生成 token 的单轮 rollout:
- Prefill 阶段记录
n_input行 routing。 - 前
n_decode - 1个生成 token 会在后续 decode step 中重新作为 input,因此各记录一行 routing。 - 最后一个生成 token 没有再次作为 input,不会产生 routing。
因此一轮可记录和 replay 的 routing 行数为 n_input + n_decode - 1。
多轮语义#
多轮对话中,R3 维护与 input_ids 按 position 对齐的全局 routing buffer。每轮会把真实 routing 追加到 buffer,并在本轮最后一个、尚未产生 routing 的 token 位置写入 -1 sentinel。
[历史 token][本轮新增 prompt][本轮 decode]
[已记录 routing ][本轮 routing ][-1]
Replay 时:
- 有有效 expert ID 的历史位置强制复用已记录 routing。
-1位置和本轮新增 prompt 没有历史 routing,继续使用模型原生 top-k gating。- R3 只复现真实观察到的 routing,不为没有执行过 forward 的 token 构造伪 routing。
启用与支持范围#
- 建议直接使用最新 SDK;最低版本要求为 Single Rollout >= 0.6.2、Group Rollout >= 0.7.3。
- Seed 2.0 模型在 GRPO、GRPOLoRA、PPO、OPD(仅 sampled token)训练方式下,使用满足要求的 SDK 提交时默认开启
enable_routing_replay=true。 - 如需对比或排障,可按当前 SDK / CLI 类型定义显式设置
enable_routing_replay;参数位置和可用范围以当前版本为准。
观测与排障#
建议重点观察:
rollout_off_policy_kl:rollout_logprobs - old_logprobs。rollout_off_policy_kl_k3:基于 K3 估计的 rollout/old logprobs 差异。ppo_kl、pg_clipfrac、pg_clipfrac_lower:Actor forward 与 update 的一致性。routing_replay/discarded_in_collate:被丢弃的 routing replay 数据量。routing_replay/object_store_count:Routing buffer 是否在消费后释放。
如果 logprobs diff 没有明显收敛,请依次确认 SDK 版本、目标模型与训练方式支持范围、任务是否实际开启 R3,以及多轮对话中 response ID 和增量消息是否正确维护。
PPO critic decouple#
PPO critic decouple 支持只向 critic 注入额外 context,而不让 policy model 看到这些信息。例如在数学任务中,可以向 critic 提供参考答案或评分 rubric,帮助 value model 更准确地评价 trajectory,同时避免答案泄漏给 actor。
只要 Rollout plugin 返回非空 critic_context,训练引擎就会启用 critic decouple,无需额外开关。
from ark_sdk.types.pipeline_plugin.rollout import CriticContext
reference_answer = (sample.extra or {}).get("answer")
critic_context = [
CriticContext(
qa_index=0,
message=ChatCompletionMessage(
role="user",
content=(
"reference answer: "
f"<answer>{reference_answer}</answer>"
),
),
).model_dump(exclude_none=True)
]
return RolloutResult(
status=PluginStatus.SUCCESS,
config={"critic_context": critic_context},
)
qa_index 按 policy model 返回的 assistant 轮次计数,而不是按 messages 数量计数。例如 system prompt 中包含多条 messages,但希望在第一轮 assistant 回复前插入 critic context 时,仍设置 qa_index=0。
使用时请注意:
- 参考答案、rubric 等只放入
critic_context,不要追加到 policy model 可见的 messages。 - 在数据预处理阶段校验
sample.extra中存在所需字段,避免构造空 context。 - Context 过长会增加 critic 计算成本,应只保留评分必要信息。
- 可通过训练日志中的
train/critic/context/n_tokens_injected或同类指标确认注入 token 数量。