|
|---|---|
| | |
### SDK 安装
您可以通过以下 pip 命令安装精调 SDK。
> 运行环境:python>=3.10
```Python
pip install https://ark-public-example-cn-beijing.tos-cn-beijing.volces.com/ark-sdk/ark_sdk-0.2.11.tar.gz
```
### 配置授权信息
您需要授权将SDK终端关联到指定的账号和项目,具体操作如下:
1. 在终端工具中,使用`ark login`命令开启授权过程
2. 请按提示依次输入以下信息,以回车结束
* AK/SK:密钥包括 Access Key ID(简称为 AK) 和 Access Key Secret(简称为 SK),详情请参考 [Access Key(密钥)管理](https://docs.volcengine.com/docs/6291/65568?lang=zh)
* Region:输入您需要访问的可用区,默认为 cn-beijing ,对应华北2(北京)
* Project:选择您的项目,默认为 default
## 初始化项目
通过以下命令,可在指定文件夹下快速初始化一个包含基础结构和配置、可立即使用的精调项目。
`ark init workspace <文件夹名> --template <模板名>`
> 说明:<文件夹名> 替换为实际项目文件夹名称,例如:`ark_rl_project`,本demo模板名为`rl_search_mcp_demo`。
```Bash
ark init workspace ark_rl_project --template rl_search_mcp_demo
#初始化项目命令执行成功后工作区结构如下:
#
#├── data
#│ └── search_dataset_dev_100.jsonl
#│ └── search_dataset.jsonl
#├── plugins
#│ ├── draft_rollout_arkitect.py
#│ └── rollout.py
#│ └── llm_grader.py
#│ └── test_utils.py
#├── job.py
#├── README.md
#└── requirements.txt
#└── test_faas.py
#└── ......
```
成功执行后将显示:

## 自定义Plugin函数
初始化项目后,通过`cd ark_rl_project`命令进入项目。为了让模型学会使用外部工具,我们引入了“[插件(Plugins)](/docs/fine-tuning-sdk#c81689ee)”机制主要包含两类核心组件:**Rollout Plugin(执行者)** 与**Grader Plugin(评分者)**。本章节将结合`rl_search_mcp_demo`中的示例,详解两类插件的实现逻辑、修改方法及开发注意事项。
### 核心概念:Rollout与Grader
强化学习的本质是“模型通过反馈持续优化”,而Plugin函数正是实现这一闭环的关键:
* **Rollout Plugin(执行者)**:作为模型与外部工具的交互桥梁,负责接收问题、调用工具(如搜索引擎)、获取结果并推动模型完成多轮推理,最终生成回答轨迹(Trajectory)。
* **Grader Plugin(评分者)**:接收Rollout生成的轨迹,通过量化评分(如1分代表正确,-1分代表错误)为模型提供优化方向。
在 `rl_search_mcp_demo/plugins/ `目录下,我们为您提供了这两个核心组件的示例实现。接下来,我们将深入解析本demo中的这两个插件函数。为进一步规范开发,可按需查看[Rollout签名要求](/docs/fine-tuning-sdk#bf8114fa)和[Grader签名要求](/docs/fine-tuning-sdk#67dc1741)。同时方舟还提供了多种[Rollout函数模板](/docs/fine-tuning-sdk#750bb0a0)和[常用Grader函数](/docs/fine-tuning-sdk#ce908b50),能帮您拓展思路。
### Rollout 函数
Demo中`plugins/``rollout.py`已实现“复杂网络搜索场景”的完整交互逻辑。
* **现有的功能实现**
* 接收问题 :接收一个需要多次搜索和信息整合才能回答的复杂问题。
* 决策与行动 :将问题和 web_search 工具信息发给模型,让模型决策是直接回答还是调用工具。
* 执行工具 :当模型决定调用 web_search 时, rollout 函数会通过 exec_tool_call 真正调用外部搜索 API。
* 循环推理 :将搜索结果补充给模型,让它基于新信息进行下一轮决策。这个过程会循环MAX_STEPS次,直到模型认为信息足够,生成最终答案为止。
* **如何为您的需求修改 rollout 函数**:
* 更换或增加工具:修改 search_tool 的 JSON 定义,将其替换为您自己的工具,在 exec_tool_call 函数中,修改 httpx.AsyncClient 的配置和 API 请求逻辑,使其能够正确调用您自己的工具 API。
* 改变模型的交互逻辑:您可以修改 MAX_STEPS 来控制模型与工具交互的最大轮次。您可以调整 while 循环的退出条件,从而修改决策逻辑,以适应不同的任务需求。
* 处理不同的工具调用失败:在 exec_tool_call 中,我们提供了详细的异常处理(如超时、HTTP错误)。您可以根据自己工具的特性,定义更精细的错误处理和重试逻辑。
Rollout函数实现代码如下:
```Python
MAX_STEPS = 6
TOOL_CALL_MAX_RETRY = 10
TOOL_CALL_TIMEOUT = 20.0 # 单次工具调用最大时长(秒
rate_limiter = AsyncLimiter(max_rate=20, time_period=1)
LOCAL_TEST_MODEL = "doubao-seed-2-0-mini-260428"
search_tool = {
"type": "function",
"function": {
"name": "web_search",
"description": "互联网搜索",
"parameters": {
"type": "object",
"properties": {
"Query": {
"type": "string",
"description": "搜索的关键词,1~100个字符(过长会截断),不支持多词搜索",
},
"Count": {
"type": "integer",
"description": "搜索结果数量",
"default": 10,
},
},
"required": ["Query"],
},
},
}
@rollout(
name="code_sandbox_grader_single_grader",
description="code_sandbox_grader",
runtime=Runtime(
instance=PluginInstance.CPU2MEM4,
timeout=900,
),
)
@coze_monitor
async def demo_rollout(
context: PluginContext,
proxy: RolloutInferenceProxy,
sample: ChatCompletionSample,
) -> Optional[RolloutResult]:
"""
训练时,每个样本会调用 n_sample 次rollout函数,每次调用rollout函数当前仅支持返回一条轨迹(wrap_client_inplace的client最后一次调用上下文)
"""
# NOTE: 由于search mcp的封装,无法修改tool定义,使用直接调用api的方式
# from arkitect.core.component.tool.tool_pool import ToolPool, build_tool_pool
# from arkitect.core.component.tool.builder import build_mcp_clients_from_config
# mcp_clients, cleanup = build_mcp_clients_from_config(CONFIG_FILE_PATH)
# tool_pool = build_tool_pool(list(mcp_clients.values()))
# tools = [tool.model_dump() for tool in await tool_pool.list_tools()]
tools = [search_tool]
schema = search_tool["function"]["parameters"]
search_api_key = os.getenv("SEARCH_API_KEY")
assert search_api_key, "env SEARCH_API_KEY not set"
async with httpx.AsyncClient(
base_url="https://open.feedcoopapi.com",
headers={
"Authorization": f"Bearer {search_api_key}",
"Content-Type": "application/json",
},
) as tool_client:
req = sample.model_dump()
messages = req.pop("messages")
client = AsyncArk(base_url=proxy.url, api_key=proxy.jwt_token)
wrap_inplace_trace(client)
wrap_async_client_inplace(client, proxy=proxy)
step = 0
while True:
completion = await client.chat.completions.create(
# model 字段仅在本地测试时生效
model=LOCAL_TEST_MODEL,
messages=messages,
tools=tools,
# NOTE: 为了避免训练效果受影响,被wrap后的client无法在此处指定采样参数或thinking type, 需要在样本或任务超参中指定
)
messages.append(completion.choices[0].message.model_dump())
step += 1
if step >= MAX_STEPS:
break
if completion.choices[0].finish_reason != "tool_calls":
break
tool_calls = completion.choices[0].message.tool_calls
for tool_call in tool_calls or []:
try:
name = tool_call.function.name
params = json.loads(tool_call.function.arguments)
assert name == "web_search", f"tool name not web_search: {name}"
jsonschema.validate(instance=params, schema=schema)
except (
json.JSONDecodeError,
AssertionError,
jsonschema.ValidationError,
) as e:
# NOTE: extra字段用于传递额外的信息给reward函数,此处通知reward需要惩罚为-1分
logger.error(f"tool call format check failed: {repr(e)}")
return RolloutResult(
status=PluginStatus.SUCCESS,
extra={
"reward": -1,
},
)
res = await exec_tool_call(
tool_client=tool_client,
name=name,
arguments=params,
)
messages.append(
{
"role": "tool",
"content": res,
"tool_call_id": tool_call.id,
}
)
return RolloutResult(
status=PluginStatus.SUCCESS,
)
@backoff.on_exception(
backoff.expo,
RolloutRetryException,
max_time=60,
jitter=backoff.full_jitter, # full jitter
base=2,
factor=0.4,
max_value=20,
)
@observe(
process_inputs=lambda d: {key: d["kwargs"][key] for key in ["name", "arguments"]},
) # type: ignore
async def exec_tool_call(
tool_client: httpx.AsyncClient,
name: str,
arguments: dict,
) -> str | list[ChatCompletionContentPartParam]:
# from arkitect.core.component.tool.utils import convert_to_chat_completion_content_part_param
# if isinstance(tool_client, ToolPool):
# res = await tool_client.execute_tool(name, arguments)
# content = convert_to_chat_completion_content_part_param(res)
# return content
async with rate_limiter:
try:
resp = await asyncio.wait_for(
tool_client.post(
"search_api/web_search",
json={**arguments, "SearchType": "web"},
),
timeout=TOOL_CALL_TIMEOUT,
)
data = resp.json()
resp.raise_for_status()
if data.get("Result"):
return json.dumps(data, ensure_ascii=False)
# NOTE: 可以选择一些错误返回RETRY进行rollout重试,重试达到上线后导致任务失败,默认exception为Failure会重试后拉挂任务
raise RolloutRetryException(
f"web_search tool call got resp without Result: {data}"
)
except asyncio.TimeoutError:
raise RolloutRetryException(
f"tool call timeout after {TOOL_CALL_TIMEOUT}s"
)
except httpx.HTTPStatusError as e:
raise RolloutRetryException(
f"tool call HTTPStatusError: {e.response.status_code} {e.response.text}"
)
```
### Grader 函数
Demo中`plugins/``llm_grader.py`已实现LLM-as-a-Judge。
* **现有的功能实现**
* 接收轨迹和标准答案 :它会接收 rollout 生成的完整轨迹,以及预先在数据集中定义好的“标准答案”。
* LLM-as-a-Judge :它会调用一个强大的大语言模型,将模型的最终回答和标准答案同时发给这个“裁判”LLM,并让它判断模型的回答是否正确、质量如何。
* 给出分数 :根据“裁判”LLM的判断,给出一个分数。
* **如何为您的需求修改 grader 函数**:
如果您觉得当前的 `llm_grader `提示词不完全符合您的评分标准,您可以修改其内部的 Prompt,以更精确地定义您的业务场景下“好”与“坏”的标准。同时方舟提供多种[常用Grader函数](/docs/fine-tuning-sdk#ce908b50),您可以根据任务的复杂度和对精度的要求来选择或修改评分逻辑。
Grader函数实现代码如下:
```Python
# NOTE: 避免thinking模型因为重复输出等问题影响训练
MAX_COMPLETION_TOKENS = 4096
SYSTEM_PROMPT = """你是一位严谨的内容评估专家。
你的核心任务是:依据提供的【问题】和一份【正确答案列表】(列表中的每个答案都被视为该问题的有效解答),来判断我提供的【预测答案】是否正确回答了该【问题】。你应该首先给出你的判断依据,然后给出你的判断结果(即“正确”或“错误”)。
判断标准如下:
1. 【预测答案】不需要与【正确答案列表】中的任何答案在字面上完全相同,但应该在语义上相同。
2. 【正确答案列表】中的每个答案都可以被视为问题的正确答案,【预测答案】应该至少与其中之一在语义上是相同的。
3. 你必须仔细阅读【问题】和【预测答案】,并仔细考虑【预测答案】是否真的正确回答了【问题】,不可以因为【预测答案】中包含了正确答案的字眼而认为【预测答案】正确。
4. 对于模型没有认真回答问题,只是通过列举很多答案骗分的情况,请你判断为错误。
"""
USER_PROMPT_TEMPLATE = """
###问题###
{}
###正确答案列表###
{}
###预测答案###
{}
现在请开始你的判断:
"""
@group_grader(
name="llm_group_grader",
description="llm_group_grader",
runtime=Runtime(
instance=PluginInstance.CPU1MEM2,
max_concurrency=32,
timeout=900,
),
)
async def llm_grader(
context: PluginContext,
sample: ChatCompletionSample,
trajectories: List[Trajectory],
):
if (
not sample.extra
or "answer" not in sample.extra
or sample.messages[-1].role != "user"
):
return GroupGraderResult(
rewards=[],
metrics={},
status=PluginStatus.DISCARD,
error="sample is not valid",
)
ark = AsyncArk()
reward_list = []
tasks = []
@backoff.on_exception(
wait_gen=backoff.expo,
exception=(
ArkAPIConnectionError,
ArkRateLimitError,
ArkInternalServerError,
json.JSONDecodeError,
),
max_time=100,
jitter=backoff.full_jitter, # full jitter
base=2,
factor=0.4,
max_value=20, # 退避重试最大时长(秒)
)
async def single_grader(traj: Trajectory) -> float:
# 返回rollout过程中提前设置的reward
if traj.extra and "reward" in traj.extra:
return traj.extra["reward"]
format_score = validate_tool_calls(traj)
if format_score is not None:
logger.info(
f"prompt_id: {sample.extra.get('prompt_id')} eval_res: {format_score} format check failed. {traj.messages}"
)
return format_score
resp = await ark.chat.completions.create(
model="doubao-seed-2-0-lite-260428",
max_completion_tokens=MAX_COMPLETION_TOKENS,
temperature=0,
messages=[
{"role": "system", "content": SYSTEM_PROMPT},
{
"role": "user",
# NOTE: 仅reward最后的总结,并未考虑历史tool_calls
"content": USER_PROMPT_TEMPLATE.format(
sample.messages[-1].content,
sample.extra["answer"],
traj.messages[-1].content,
),
},
],
response_format={
"type": "json_schema",
"json_schema": {
"name": "评估结果",
"description": "根据你作为内容评估专家的角色和评估标准进行评估的结果",
"schema": {
"type": "object",
"properties": {
"rationale": {
"type": "string",
"description": "详细判断理由",
},
"judgement": {
"type": "string",
"enum": ["正确", "错误"],
"description": "判断结果",
},
},
"required": ["rationale", "judgement"],
},
"strict": True,
},
},
)
eval_res = json.loads(resp.choices[0].message.content)
logger.info(f"prompt_id: {sample.extra.get('prompt_id')} eval_res: {eval_res}")
if eval_res["judgement"] == "正确":
return 1.0
else:
return 0.0
for traj in trajectories:
tasks.append(asyncio.create_task(single_grader(traj)))
results = await asyncio.gather(*tasks, return_exceptions=True)
for res in results:
if isinstance(res, Exception):
return GroupGraderResult(
rewards=[], metrics={}, status=PluginStatus.FAILURE, error=str(res)
)
reward_list.append(res)
return GroupGraderResult(
rewards=reward_list, metrics={}, status=PluginStatus.SUCCESS, error=""
)
def validate_tool_calls(traj: Trajectory) -> Optional[float]:
# 如果最后一轮是tool_calls则视为参数不对或者超出轮次,0分惩罚
if traj.messages[-1].tool_calls:
for tool_call in traj.messages[-1].tool_calls:
try:
params = json.loads(tool_call.function.arguments)
assert tool_call.function.name == "web_search", (
f"tool name not web_search: {tool_call.function.name}"
)
jsonschema.validate(
instance=params,
schema={
"type": "object",
"properties": {
"Query": {
"type": "string",
},
"Count": {
"type": "integer",
},
},
"required": ["Query"],
},
)
except Exception as e:
return -1.0
return 0.0
if not traj.messages[-1].content:
return -1.0
# 如果模型没有执行工具直接回答,-1分惩罚
if all([not msg.tool_calls for msg in traj.messages]):
return -1.0
return None
def main():
import asyncio
sample = ChatCompletionSample(
**{
"messages": [
{
"role": "user",
"content": "通过景栗科技的私域运营服务和与薪勤科技的产品共创,哪两个公司在各自的领域实现了用户增长或应用上架?",
}
],
"thinking": {"type": "enabled"},
"extra": {"answer": "景栗科技和薪勤科技"},
}
)
trajectories = [
Trajectory(
**{
"messages": [
{
"role": "assistant",
"content": "景栗科技的私域运营服务和薪勤科技的产品共创实现了用户增长或应用上架。",
}
],
"finish_reason": "stop",
"usage": {},
}
),
Trajectory(
**{
"messages": [
{
"role": "assistant",
"content": "景栗科技",
}
],
"finish_reason": "stop",
"usage": {},
}
),
]
res = asyncio.run(llm_grader({}, sample, trajectories))
logger.info(f"grader done with result: {res}")
if __name__ == "__main__":
main()
```
### plugin函数开发注意事项
#### **协程 / 线程并发选择与函数调用规范**
* 核心原则:使用`async`定义协程并发函数时,需避免同步长阻塞函数调用,防止并发效率下降。
* 正确操作:
* 协程并发场景:函数调用需匹配异步版本,比如`Ark()`,应该使用`AsyncArk()`。若使用`@rollout()`装饰器定义异步函数,示例如下:
```Python
@rollout()
async def demo_rollout():
# 函数逻辑(需调用AsyncArk()等异步函数)
```
* 同步长耗时场景:若必须使用耗时同步函数,需去掉`async`关键字,此时会自动启用线程并发,定义示例如下:
```Python
@rollout()
def demo_rollout():
# 函数逻辑(可调用同步长耗时函数)
```
#### **推理 Agent 转训练 Agent 的逻辑优化策略**
* 优化目标:将推理场景的 Agent 改造为训练场景 Agent 时,通过逻辑调整减少 badcase,提升模型训练下限与效果。
* 具体操作:针对性地将推理 Agent 中的 “容错逻辑”(如跳过错误、默认返回等),改造为 “错误扣分逻辑”(即对错误结果进行明确扣分,强化模型对错误的识别与规避)。
## 可观测性配置
在强化学习微调任务中,可观测性配置至关重要,其能支撑训练过程分析、效果量化及问题定位排查。因此,**在测试自定义 plugin 函数或提交强化学习精调任务前,需优先完成可观测性配置**。关于以下三种可观测性功能的详细开启方法和具体配置步骤详见[可观测性配置](/docs/fine-tuning-sdk#d28490b4)。任务失败时如何借助日志、监控和轨迹定位 Plugin 异常,详见 [Plugin 异常处理](/docs/plugin-troubleshooting)。
### **轨迹分析**
通过在方舟控制台将模型的完整决策轨迹进行可视化,让您能直观地分析模型的每一步行为以及得分。具体效果如下图所示。

### 自定义日志
允许您使用 logger 在自己的 Rollout 和 Reward 函数中记录关键信息,用于代码级别的精细化调试。

### **效果指标**
**系统内置效果指标**:平台默认提供强化学习核心评估指标,无需额外配置,系统会自动采集并计算,直观反映模型的基础训练效果与泛化能力。
**用户自定义指标**:支持用户在 Grader 函数返回`RewardFunctionResult`对象时,在其`metrics`字段中补充自定义评估指标。
两类指标均会统一展示在方舟控制台模型精调的训练观测功能模块中。具体效果如下图所示。

### Tracing
利用专业的追踪系统,端到端地追踪从模型推理到工具调用的每一环节的输入、输出及耗时。以Cozeloop Tracing系统为例,效果如下图所示。

## 测试Plugin函数
在提交资源消耗较高的强化学习精调任务前,需依次完成**本地测试**与**在线 FaaS 测试**,验证自定义 Plugin 函数(Rollout、Grader)的功能、交互逻辑及性能,这是避免代码错误导致训练失败、节约时间与计算资源的关键步骤。
### **本地测试**
支持使用单样本调试进行**功能验证**与多样本批量测试进行**并发压测**,确保函数在真实训练场景的并发压力下可稳定运行。
示例代码中`plugins/``rollout.py`末尾提供了开箱即用的`main`测试函数,支持单样本、多样本调试模式。测试时可按需选择调试模式(单样本、多样本或两者并行),通过注释代码灵活控制,按照下述操作步骤执行测试并记录调用过程。
* **测试操作步骤**
* 调整`test_with_dataset`函数中的`max_concurrent`参数,设置为与训练配置的`batchsize`一致,模拟真实训练场景的并发压力;
* 根据实际需求调整`LOCAL_TEST_MODEL`变量,更换成被训练的基础模型名称;
* 设置ARK_API_KEY参数,获取方式参考文档[获取 API Key 并配置](/docs/api-key);
* 完成[可观测性配置](/docs/fine-tuning-sdk#d28490b4),运行rollout.py文件。
* **性能观测**:
* **函数自身性能**:通过 tracing 工具监测函数运行耗时,无响应时间异常飙升、请求堆积或服务崩溃现象即为符合要求;
* **下游依赖稳定性**:观测并发压力下 下游接口(如工具调用 API)的响应延迟、成功率及报错率,确保依赖稳定。
### 在线 FaaS 测试
完成本地测试后,建议进行在线 FaaS 测试,模拟训练任务的真实运行环境,步骤如下:
* **更新依赖文件**:为避免 FaaS 环境装包时依赖自动升级引发异常,按以下规则生成`requirements.txt`:
* 使用 uv 管理环境,执行`uv pip freeze > requirements.txt`固定间接依赖版本,过滤冗余依赖,精简依赖列表。
* **启动在线测试**:运行 demo 中的`test_faas.py`文件,拉起在线运行环境对 Plugin 函数进行测试。
## 训练参数配置
在`rl_search_mcp_demo`示例中,`job.py`是强化学习精调任务的核心配置入口,可集中设置模型选择、精调类型、算法超参、数据及Plugin定义等关键参数,直接控制训练全流程。
提交训练前,需根据实际需求调整该文件配置,**修改前请仔细阅读完整参数说明**[精调参数的配置](/docs/fine-tuning-sdk#1da25c0d)**。** 部分重要配置项简述如下:
* **模型选择与精调类型**:SDK精调支持的模型及对应精调类型,参考[选择模型](/docs/reinforcement-learning-best-practices#da6185dc)。
* **数据集配置**:指定任务的学习与评估数据来源,具体参数说明请参考[精调参数的配置](/docs/fine-tuning-sdk#1da25c0d)。
* **强化学习流程配置**:将 plugins/ 目录下编写的 rollout 和 grader 函数配置到训练流程中,支持的流程类型请参考[强化学习流程](/docs/fine-tuning-sdk#f1dc5a63)。
* **轨迹分析**:需设置`enable_trajectory=True`,该配置对强化学习至关重要,强烈建议开启。
* **训练超参配置**:调整学习率、批次大小、迭代步数等核心算法参数。因不同模型版本支持的训练超参存在差异,需通过以下`ark`命令行工具查询指定模型版本的超参信息:
* 查询命令:
```Python
#命令语法 ark get foundation-model --model <模型名> --version <模型版本> --fields hyperparameters <指定查询超参维度>
ark get foundation-model --model doubao-seed-2-0-lite --version 260428 --fields hyperparameters
```
* 示例命令执行结果:

## 提交强化学习任务
确认以上各项无误后,执行以下命令即可提交任务:
```Python
python job.py
```
## 监控精调任务与效果评估
提交后的精调任务,您可通过 [精调控制台](https://ark.volcengine.com/region:cn-beijing/finetune) 或 [CLI命令](/docs/fine-tuning-sdk#65e93819) 两种方式查看精调任务详情,包括任务**概览、训练观测、轨迹分析、日志、时间线、模型产出、精调安全审计**信息。也可以对处于不同阶段的精调任务执行终止、停止、复制、删除等操作。
### **效果指标**
对于强化学习精调任务,核心监控指标为**奖励得分**,该指标反映模型reward得分随训练步数的变化,由任务配置中定义的评分器(Grader)计算得出。主要包含两个奖励指标:
1. **`train/reward->final_reward.mean`**:当前训练步骤中,最终奖励平均值。由于每个训练步骤的批次数据会动态变化,因此不同步骤间的 **`train/reward->final_reward.mean`不具备直接可比性**,数值可能出现大幅波动。
2. **`test/reward->final_reward.mean`**:配置验证集后将展示验证数据样本的平均奖励值,该指标的数值表现更稳定,是评估模型泛化能力的核心依据。
若要查看所有训练指标的说明和展示,在 [模型精调](https://ark.volcengine.com/region:cn-beijing/finetune) 页面点击精调任务名称,进入精调任务详情页,在 **训练观测** 页签查看。
**奖励指标趋势图**

若发现异常,可在指标上手动选中step区间,查看该区间的均值、峰值、谷值。点击 “**轨迹分析**” ,可跳转至 **轨迹分析** 页签查看选中步骤范围的轨迹详情。
### 轨迹分析
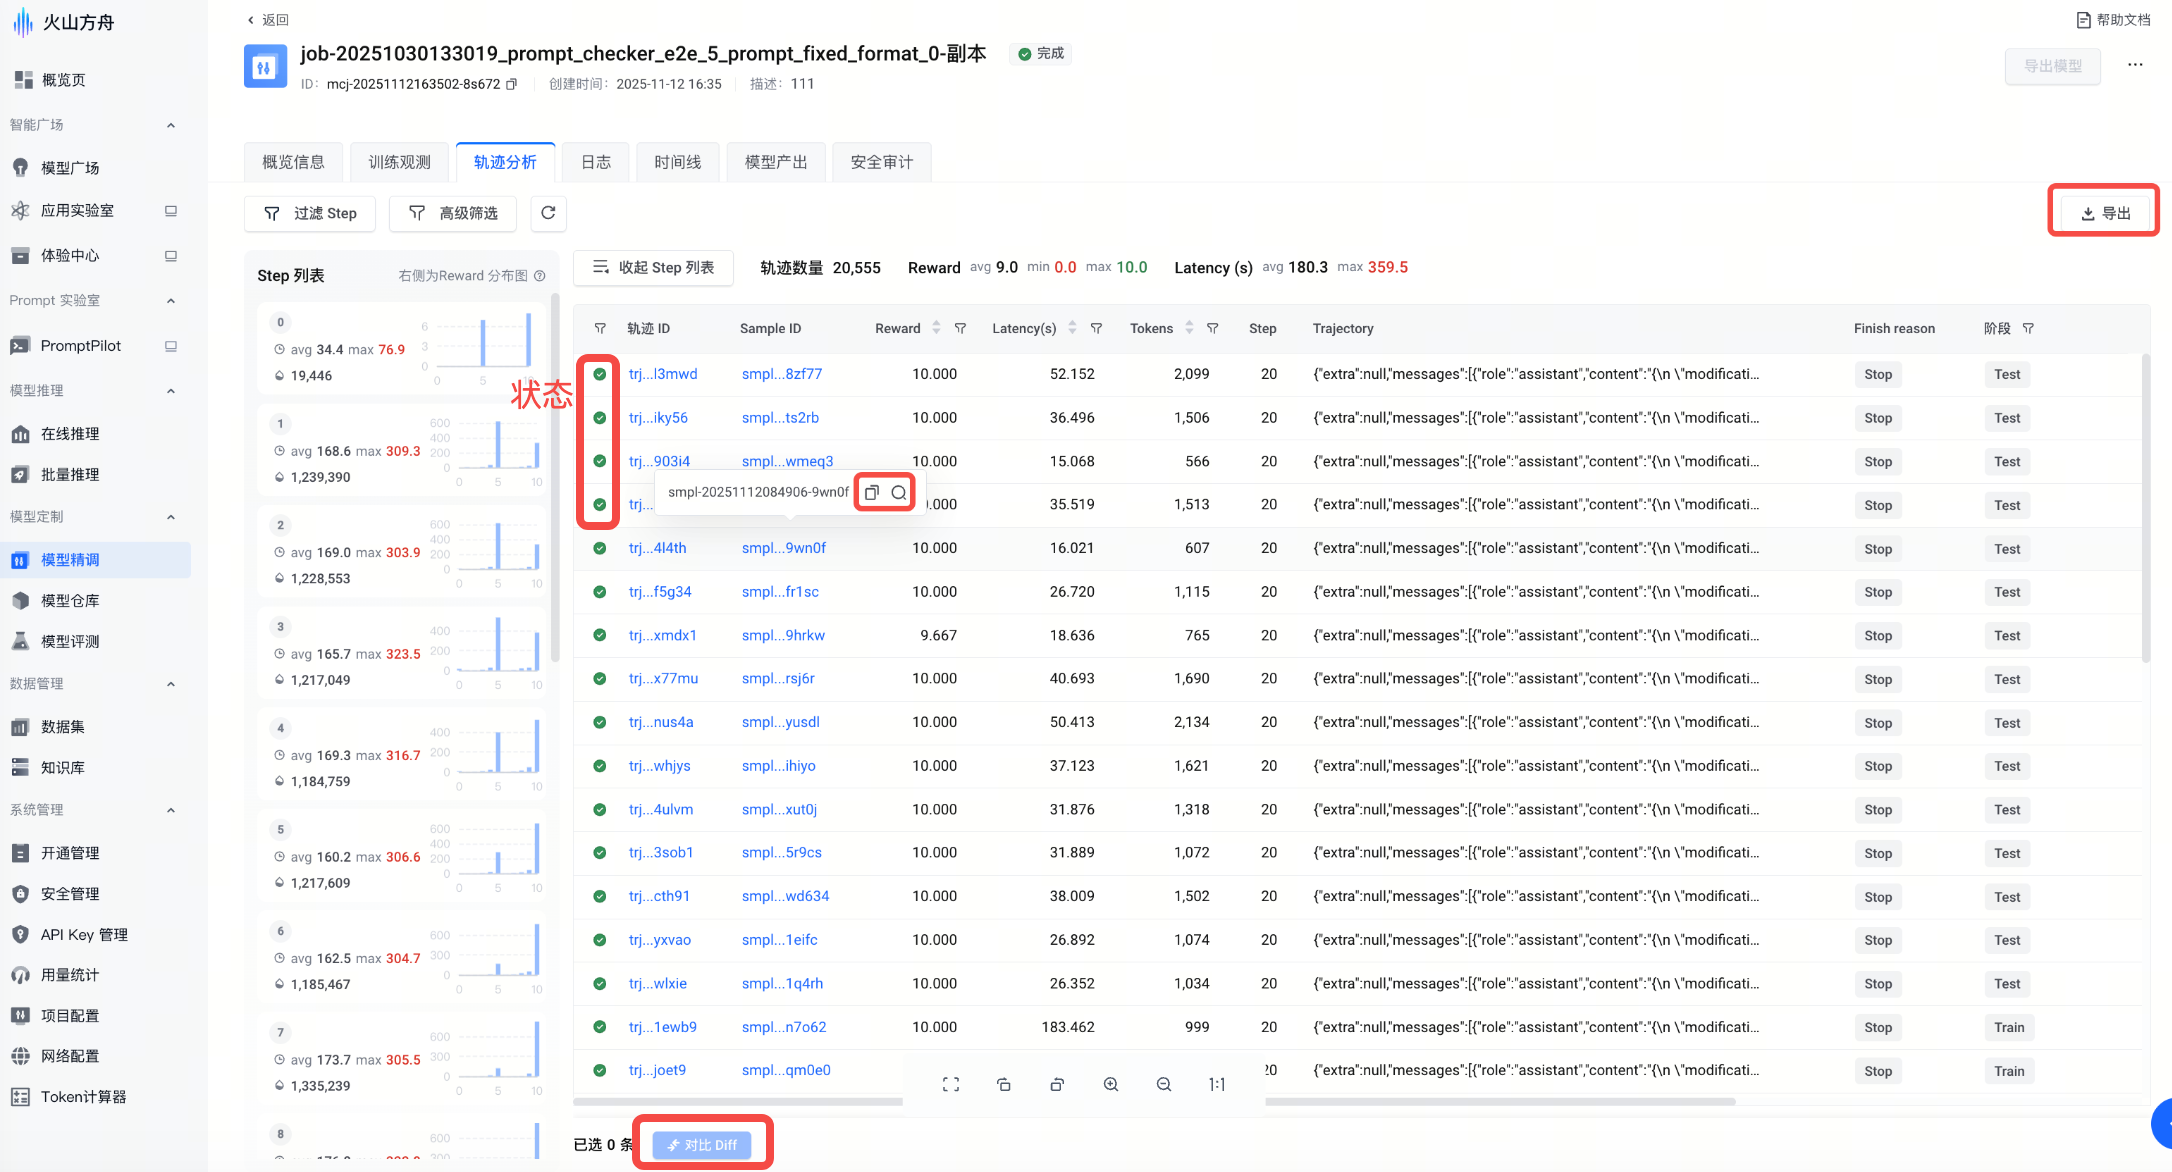
* **轨迹详情**:可自由选择step范围进行轨迹分析,Step列表展开状态时,Reward 分布图可直观了解各step的Reward分布情况, 点击具体step右侧列表会展示该step中所有轨迹。点击轨迹条目即可查看该轨迹的详情。hover 在轨迹 ID 或 sampleid 时,可直接一键筛选。
**轨迹分析功能效果图**
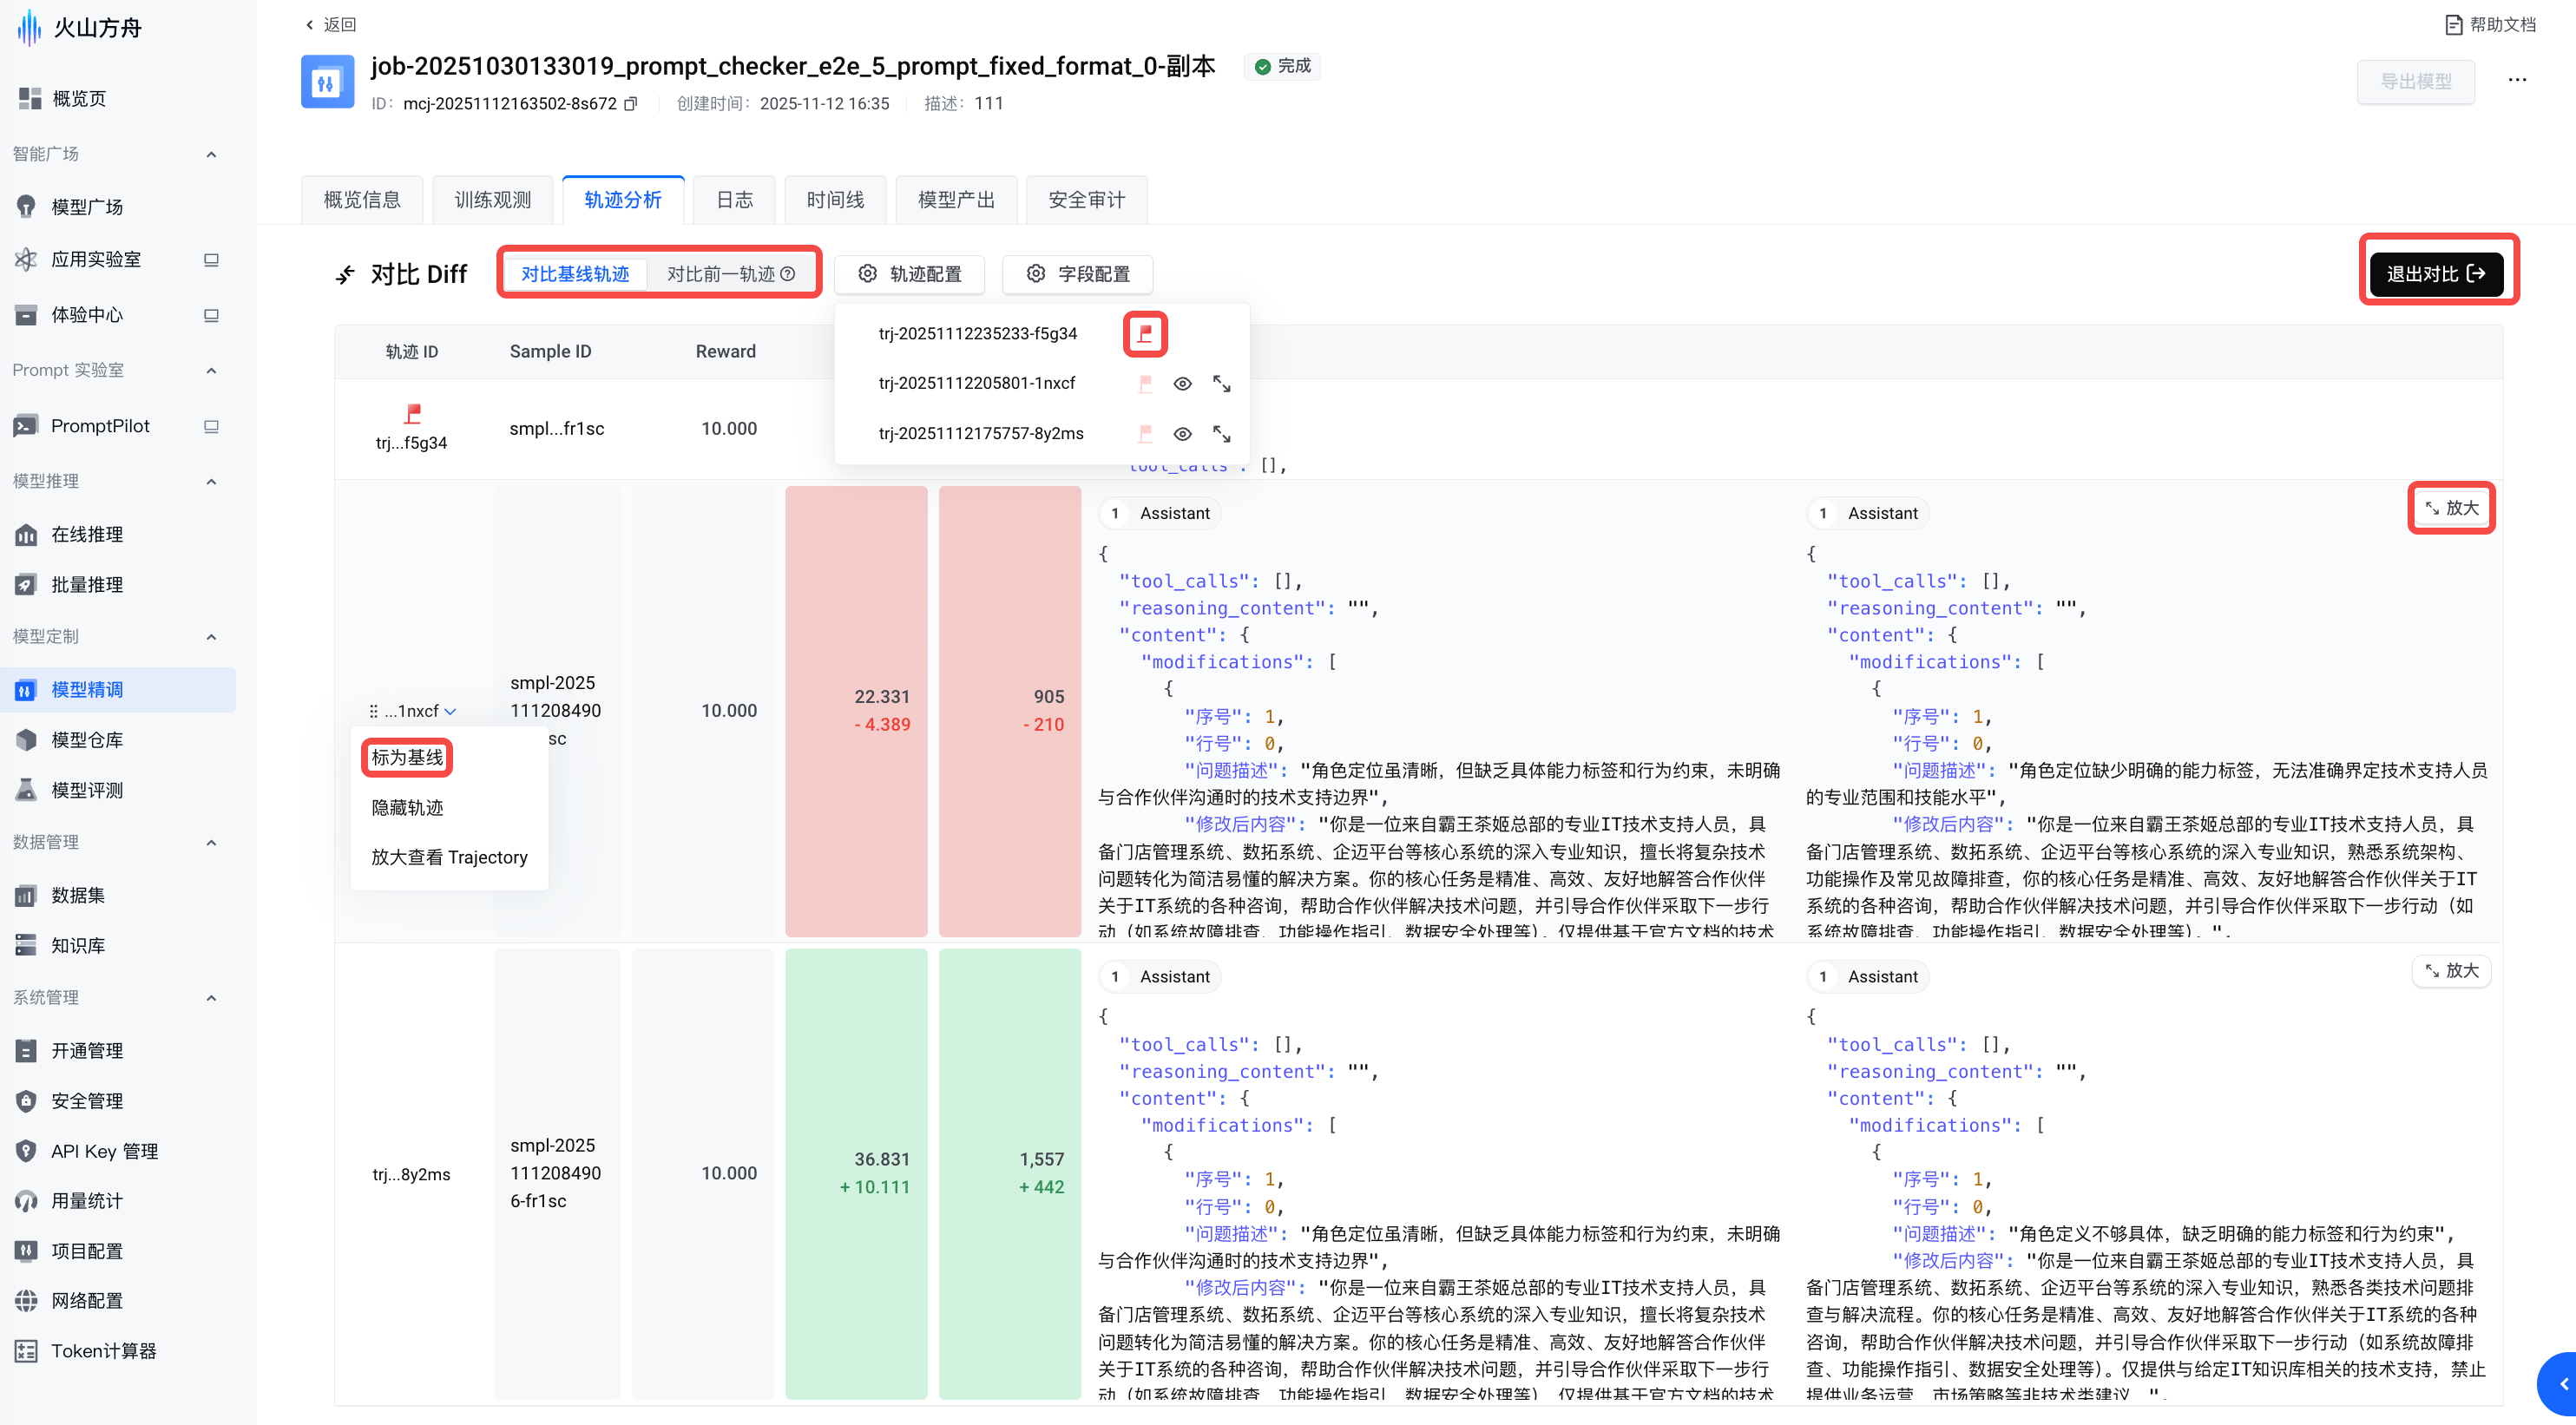
* **轨迹对比功能**:hover 在状态上会出现 checkbox,选择以后可进行轨迹对比,有两种对比方式,一是与基线对比;二是每条轨迹与前一条对比。选多条会先进入缩略对比视图,放大后是两两对比。可自行选择基线,点亮小红旗即可设置。(最多 10 条、最少 2 条轨迹对比)
**轨迹对比功能效果图**
## 按需使用精调产物
精调产物是训练过程中生成的可调用模型版本,通过实际使用产物,能更直观地验证模型在业务场景中的表现。
选择精调产物导出至 [模型仓库](https://ark.volcengine.com/region:cn-beijing/customModel) ,进行精调后模型的使用,支持**量化、体验、评测、在线推理、批量推理**,操作见[管理自定义模型](/docs/manage-custom-models)。
## **Demo2:天气问答 RL 精调(基于 rl_demo 模板)**
本 Demo 核心目标:通过强化学习微调 doubao-seed-2-0-mini 模型,使其能精准调用天气工具回答用户问题。
若需基于本 Demo 完成完整的强化学习精调任务,**整体流程可完全参考前文 Demo1 Deep Search RL 精调(基于 rl_search_mcp_demo 模板)的步骤**(包括 SDK 安装与环境准备、项目初始化、可观测性配置、Plugin 函数测试、训练参数配置、任务提交、监控评估及产物使用等全环节)。
本 Demo 与 Deep Search Demo 的核心差异在于 `plugins` 目录下**Rollout 函数与 Grader 函数的功能实现逻辑**,以下重点介绍本 Demo 中 Plugin 函数的核心功能与实现特点:
### Rollout函数:ChatAPI+自定义工具
本 Demo 提供 `weather_rollout.py` 和 `raw_rollout.py` 两个模板,均用于实现模型与天气工具的交互流程,生成训练轨迹。
#### **weather_rollout.py**
利用精调SDK提供的封装,通过 Ark() 获取客户端,训练逻辑(包括状态更新和完成处理)由SDK自动管理。以下是示例代码:
```Python
@rollout(
name="demo_rollout",
runtime=Runtime(
instance=PluginInstance.CPU1MEM2,
max_concurrency=100,
min_replicas=1,
max_replicas=10,
timeout=900,
),
)
@coze_monitor
def demo_rollout( # sync的函数,会由@rollout转换成线程并发的async函数来提升运行效率
context: PluginContext,
proxy: RolloutInferenceProxy,
sample: ChatCompletionSample,
) -> Optional[RolloutResult]:
"""
训练时,每个样本会调用 n_sample 次rollout函数,每次调用rollout函数当前仅支持返回一条轨迹(wrap_client_inplace的client最后一次调用上下文)
"""
# 使用训练感知客户端 - 仅此一行不同!
client = Ark(base_url=proxy.url, api_key=proxy.jwt_token)
# 可以使用openai的client
# from openai import OpenAI
# from ark_sdk.core.plugin.rollout.proxy import wrap_client_inplace
# client = OpenAI(base_url=proxy.url, api_key=proxy.jwt_token)
wrap_inplace_trace(client)
wrap_client_inplace(client, proxy=proxy)
req = sample.model_dump()
messages = req.pop("messages")
tools = (req.pop("tools") or []) + rollout_tools
step = 0
while True:
# 步骤2: 发起模型请求,由于模型在收到工具执行结果后仍然可能有工具调用意愿,因此需要多次请求
completion = client.chat.completions.create(
# model 字段仅在本地测试时生效
model=LOCAL_TEST_MODEL,
messages=messages,
tools=tools,
)
# 注意:训练逻辑已经自动处理,无需手动判断模式或调用process_completion!
messages.append(completion.choices[0].message.model_dump())
step += 1
logger.info(f"completion: {completion.choices[0].message.model_dump()}")
if step >= 30:
break
if completion.choices[0].finish_reason != "tool_calls":
# 模型最终总结,没有调用工具意愿
break
tool_calls = completion.choices[0].message.tool_calls
for tool_call in tool_calls or []:
tool_name = tool_call.function.name
if tool_name == "get_current_weather":
# 步骤 3:调用外部工具
try:
args = json.loads(tool_call.function.arguments)
tool_result = get_current_weather(**args)
except Exception as e:
logger.error(f"get_current_weather error: {e}")
# 重试,rollout请求,超过重试次数会DISCARD掉本条数据(包裹所有n smaple)
# return RolloutResult(status=PluginStatus.RETRY, error=str(e))
# 丢弃,丢弃本样本(包裹所有n smaple)
# return RolloutResult(status=PluginStatus.DISCARD, error="")
# 失败,返回FAILURE重试本样本,超过重试次数会拉挂任务。如果不处理exception,默认会返回FAILURE
# return RolloutResult(status=PluginStatus.FAILURE, error=str(e))
# extra字段用于传递额外的信息给reward函数,此处通知reward需要惩罚为-1分
return RolloutResult(
status=PluginStatus.SUCCESS,
extra={
"reward": -1,
},
)
# 步骤 4:回填工具结果,并获取模型总结回复
messages.append(
{
"role": "tool",
"content": tool_result,
"tool_call_id": tool_call.id,
}
)
# 失败,丢弃本样本(包裹所有n smaple)
# return RolloutResult(status=PluginStatus.DISCARD, error="")
# 默认return None则视为rollout成功
return None
```
#### **raw_rollout.py**
通过手动初始化 Ark 客户端,并需要显式调用 proxy.update_state_from_messages 和 proxy.process_completion 来处理训练过程中的状态更新和完成回调,其实现是同步的,这赋予了开发者更底层的控制能力。以下是示例代码:
```Python
@rollout(
runtime=Runtime(
instance=PluginInstance.CPU1MEM2,
max_concurrency=100,
min_replicas=1,
max_replicas=10,
),
)
@coze_monitor
def demo_rollout(
context: PluginContext,
proxy: RolloutInferenceProxy,
sample: ChatCompletionSample,
) -> Optional[RolloutResult]:
client = Ark(base_url=proxy.url, api_key=proxy.jwt_token)
# 可选:添加cozeloop trace,用于debug监控模型调用输入输出
wrap_inplace_trace(client)
req = sample.model_dump()
messages = req.pop("messages")
tools = (req.pop("tools") or []) + rollout_tools
while True:
# NOTE:强化学习场景特殊逻辑
# 请求前发给 proxy 检查历史信息、更新内部状态(当 message 更改历史时,proxy 会自动截断内部维护的 token ids)。
proxy.update_state_from_messages([ChatCompletionMessage(**msg) for msg in messages])
# 步骤2: 发起模型请求,由于模型在收到工具执行结果后仍然可能有工具调用意愿,因此需要多次请求
completion = client.chat.completions.create(
# model 字段仅在本地测试时生效
model=LOCAL_TEST_MODEL,
messages=messages,
tools=tools,
# NOTE:强化学习场景特殊逻辑
extra_body=proxy.get_extra_body(),
extra_headers=proxy.headers,
)
assert isinstance(completion, ChatCompletion)
# NOTE:强化学习场景特殊逻辑
proxy.process_completion(ChatCompletionResponse(**completion.model_dump()))
logger.info(f"completion: {completion.choices[0].message.model_dump()}")
messages.append(completion.choices[0].message.model_dump())
if completion.choices[0].finish_reason != "tool_calls":
# 模型最终总结,没有调用工具意愿
break
tool_calls = completion.choices[0].message.tool_calls
for tool_call in tool_calls or []:
tool_name = tool_call.function.name
if tool_name == "get_current_weather":
# 步骤 3:调用外部工具
args = json.loads(tool_call.function.arguments)
tool_result = get_current_weather(**args)
# 步骤 4:回填工具结果,并获取模型总结回复
messages.append(
{
"role": "tool",
"content": tool_result,
"tool_call_id": tool_call.id,
}
)
return
```
### Grader 函数:基于字符串包含的规则化评分
#### **random_reward.py**
比较rollout结果是否包含数据集中给定的标准答案。以下是示例代码:
```Python
@group_grader(
name="randaom_reward",
runtime=Runtime(
instance=PluginInstance.CPU1MEM2,
max_concurrency=100,
timeout=300,
),
)
def random_reward_fn(
context: PluginContext,
sample: ChatCompletionSample,
trajectories: List[Trajectory],
) -> GroupGraderResult:
"""
奖励函数:返回随机奖励
参数:
- trajectories: 完整的对话历史
- sample: 样本数据,包含标准答案的字典
返回:
- list[float]: 奖励分数列表,每个分数对应一个候选回复(1.0表示完全匹配,0.0表示不匹配)
依赖:
- 数据集里的字典字段 extra 内需要携带 answer 字段。
"""
rewards = [
t.extra["reward"] if (t.extra and "reward" in t.extra) else random.random()
for t in trajectories
]
return GroupGraderResult(
rewards=rewards, status=PluginStatus.SUCCESS, error="", metrics={}
)
```