# 智能模型路由
> 全部文档的索引见 [llms.txt](https://ark.volcengine.com/llms.txt);在任一文档页面地址后追加 `.md` 可获取该页的 Markdown 版本。
智能模型路由是一种通过动态分析用户请求特征(如任务类型、复杂度、实时流量等),自动匹配最合适模型进行处理的技术,帮助企业在复杂场景中实现 AI 资源的最优配置。本文为您介绍智能模型路由的定义、主要优势、使用方式等相关内容。
# 什么是智能模型路由
智能模型路由是平台依据您每次请求的 Prompt 动态匹配最合适模型的能力;您只需创建一个接入点并开启该模式,平台便会在您圈定的模型范围内,结合 Prompt 内容、效果需求及成本偏好,自动匹配最优模型响应请求。这种智能匹配机制能够确保在不同的业务场景下,都能高效且精准地利用模型资源,为用户提供更贴合需求的服务。
# 主要优势
* **最大化模型效果**:针对不同任务自动匹配最优模型,尤其适配对效果有极致需求的用户。
* **精准降低成本**:简单任务自动路由至轻量模型,复杂任务匹配高阶模型,避免 “大材小用” 的资源浪费,实现成本与需求的精准适配。
* **化解模型选择难题**:无需用户手动开展复杂的模型评测与对比,平台全程自动筛选最优解,大幅降低模型选型门槛。
* **极简使用体验**:与常规模型接入流程完全一致,用户仅需创建一个接入点,通过接入点 ID 即可调用智能路由能力,无需额外修改代码,零学习成本快速上手。
# 使用说明
## 请求限制
* 仅支持通过 [对话(Chat) API](/docs/chat-api) 调用智能模型路由,不支持 Responses API。
* 仅支持上下文长度 <32k tokens 的纯文本请求,不支持图片或视频输入。
* 不支持与上下文缓存功能一起使用。
## 参数说明
**在智能路由模式下,以下参数会影响模型的选择**:
* `thinking`:
* 设置为`enabled`:自动排除 non-thinking 模型,并自动开启 thinking。
* 设置为`disabled`:倾向选择 non-thinking 模型。
* 设置为`auto`:倾向在所有支持 thinking 和 non-thinking 的模型中选择。
* `reasoning effort`:默认仅路由到支持该参数的模型。
* `response_format`:默认仅路由到支持该参数的模型。
**在智能路由模式下,以下参数不支持使用,如果设置,会导致运行报错**:
* `top_logprobs`
* `logit_bias`
* `Stop`
* `tool_choice`
* `parallel_tool_calls`
* `logprobs`
## 其他说明
* 如果您未参与协作奖励计划,智能路由不会收集您的数据信息。
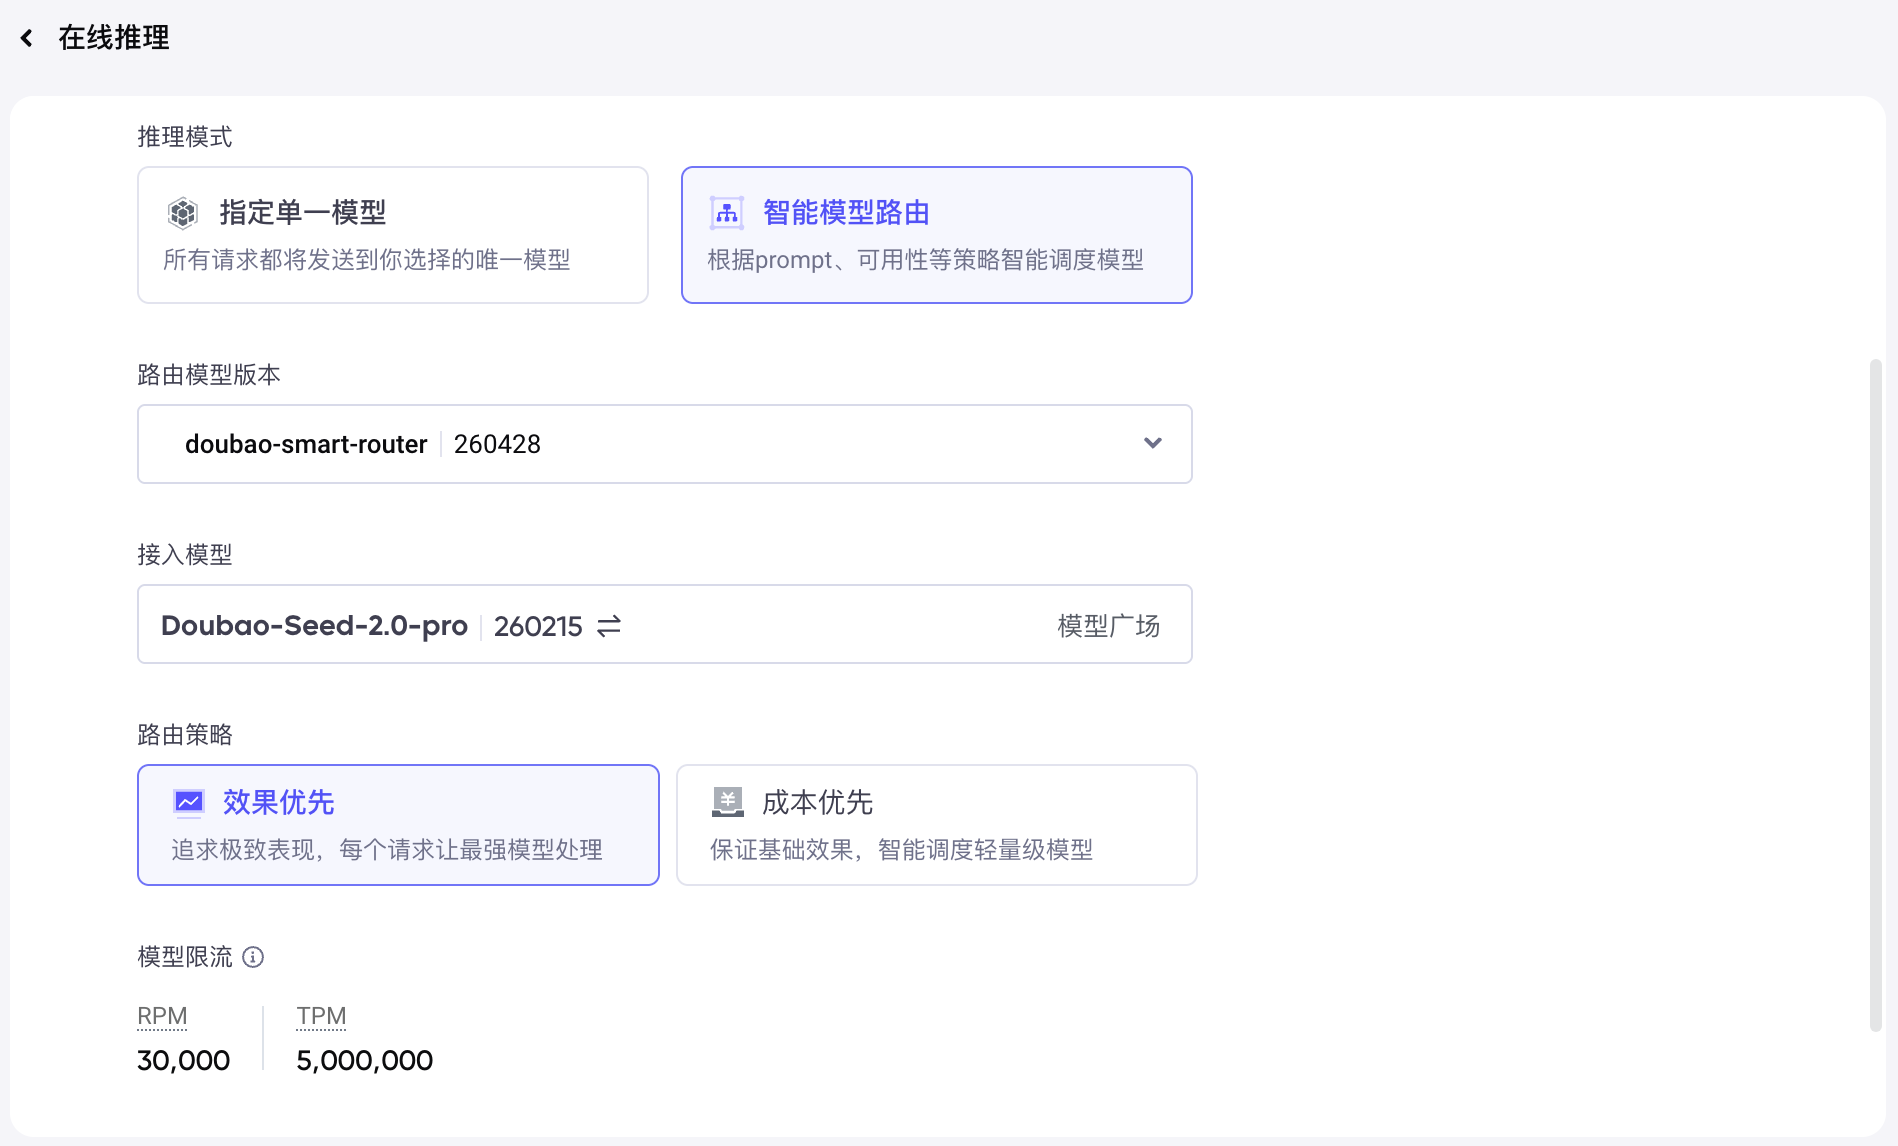
* 智能模型路由的限流为 5,000,000 TPM 30,000 RPM。当智能路由到特定模型后,将同时消耗特定模型在账号下的限流额度。
* 按实际路由到的模型计费,内测期间路由模型本身不收费。
# 使用流程
## 步骤一:创建推理接入点
1. 访问 [创建推理接入点](https://ark.volcengine.com/region:cn-beijing/endpoint/create),配置接入点信息。
1. 推理模式选择 **模型智能路由**。
2. 选择 **路由模型版本**。
路由模型版本是智能模型路由能力的标准化发布形态,每个版本明确了对应阶段下路由系统支持的模型范围、可用策略与核心能力。选定具体版本后,线上业务的路由行为将保持长期稳定;升级版本前请务必做全面评估,避免对业务产生影响。
当前提供以下两个版本:
> **注意**
>
> 新用户仅支持选择新路由模型版本;已使用过该功能的存量用户可继续使用旧版本,也可切换至新版本。
---
**旧版本:多模型自主路由**
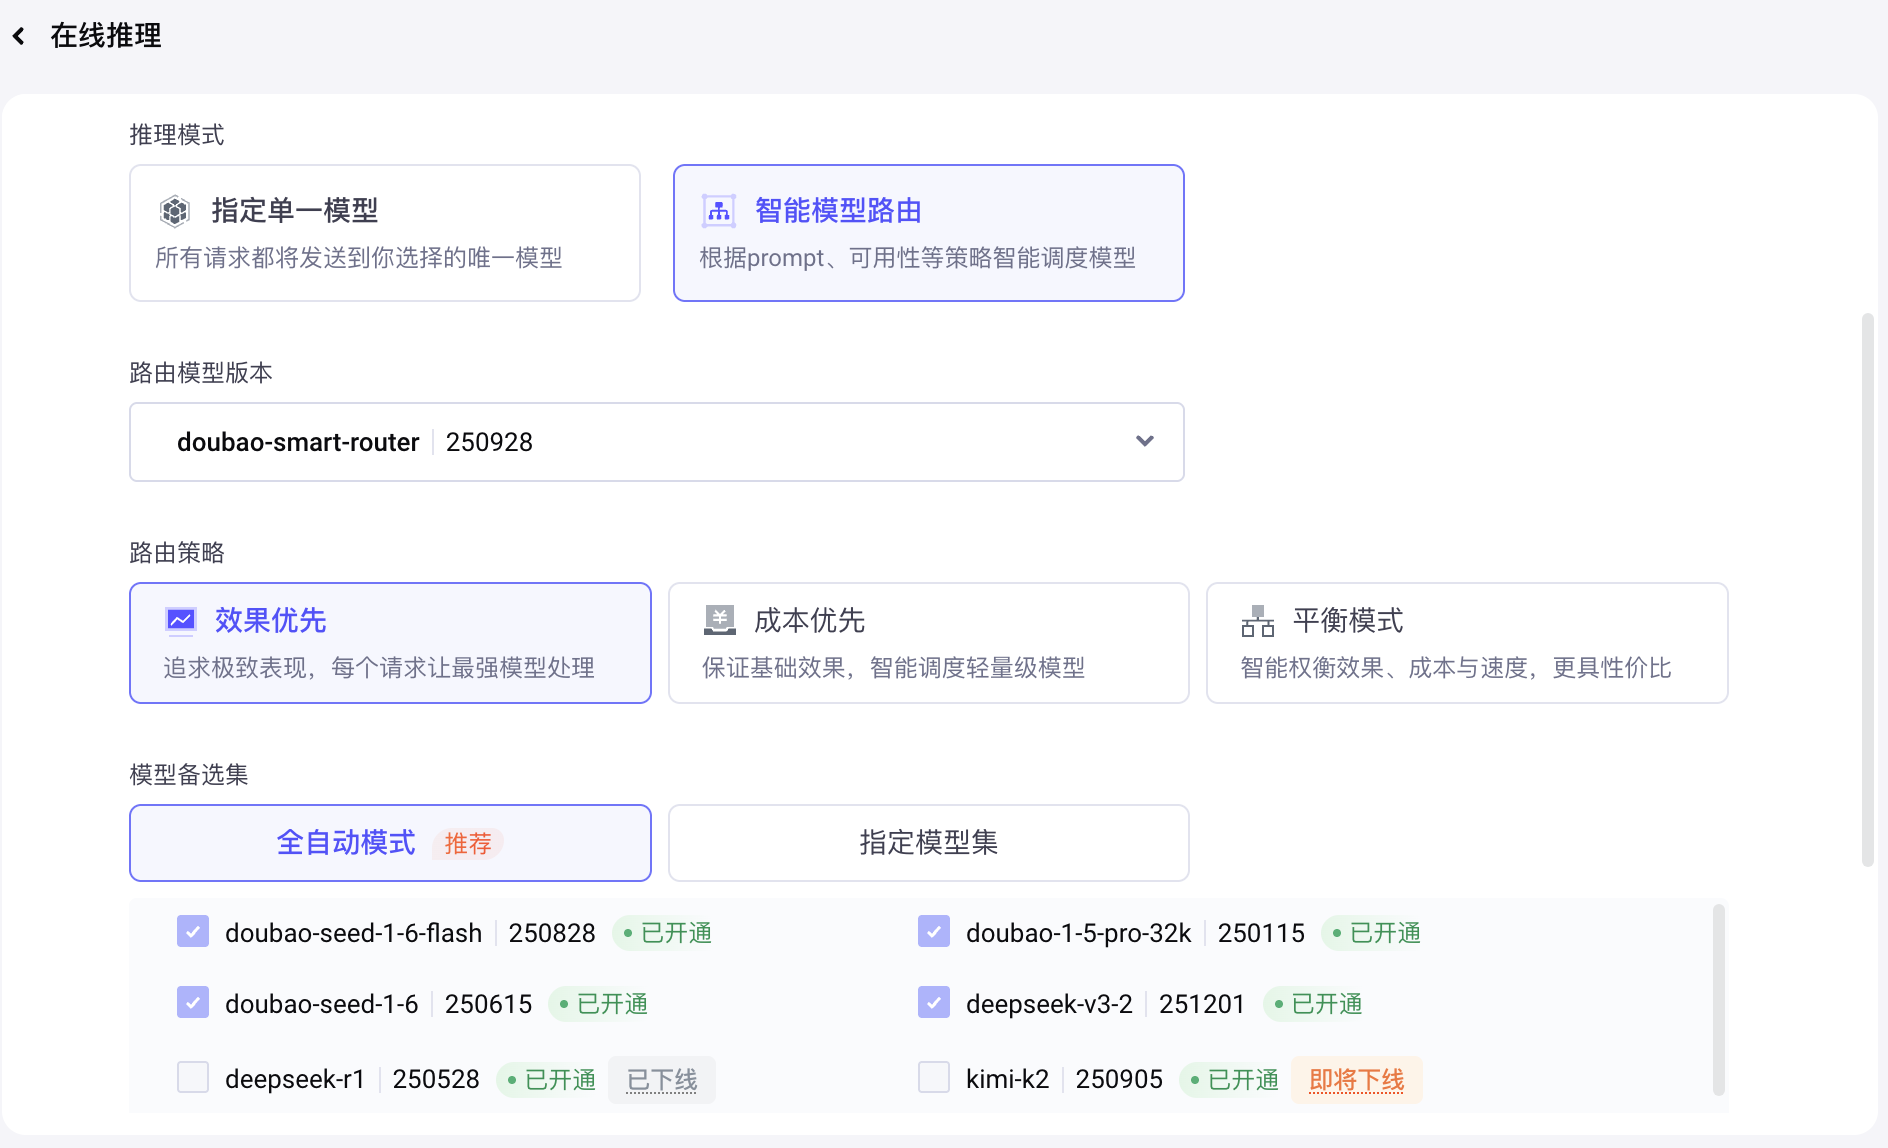
适用于希望充分利用多模型差异化优势的场景。您可指定一组备选模型并选择路由策略,平台将根据每次请求的 Prompt 内容,在备选模型中自动选择最合适的模型进行响应。
配置项:
1. 选择 **路由策略**。根据业务需求决定路由的导向逻辑:
- **效果优先**:基于场景分类,自动选择效果最优的模型。
- **成本优先**:基于请求长度,在模型备选集中选择价格最低的模型。
- **平衡模式**:基于效果、成本、速度的加权得分进行综合排序。
2. 选择 **模型备选集**。指定智能路由可选择的模型范围:
- **全自动模式**:平台自动开通全部可用模型,请求将由其中最合适的一个处理。如您关闭某个模型,路由将屏蔽该模型。
- **指定模型集**:由您手动指定智能路由的可选模型范围。
> **说明**
>
> 可选模型范围以控制台显示为准。
---
**新版本:基线模型智能降本/增效**
适用于已有明确主力模型、希望在此基础上进一步优化成本或提升效果的场景。您需要先指定一个基线模型,平台根据路由策略自动判断是否将请求切换至更优或更经济的模型,在保障业务稳定性的前提下实现降本增效。
配置项:
1. 选择 **接入模型**。从模型列表中选择一个模型作为基线。系统将以该模型的效果和成本作为参照基准,决定是否路由至其他模型。
2. 选择 **路由策略**。根据业务需求决定路由的导向逻辑:
- **效果优先**:当模型备选集中存在效果优于基线模型的模型时,系统将自动路由至该模型。
- **成本优先**:当模型备选集中存在成本低于基线模型的模型时,系统将自动路由至该模型。
> **说明**
>
> 模型备选集以控制台显示为准。
2. 按需配置其他信息,配置完成后,阅读并勾选相关协议,单击 **创建并接入**,完成推理接入点创建。
3. 在列表页复制接入点的 Endpoint ID,以便后续通过 Endpoint ID 发起模型调用时使用。
## 步骤二:通过 Endpoint ID 发起模型调用
> 调用前请确保已将 API Key 配置为环境变量 `ARK_API_KEY`(详情参见 [环境变量配置指南](/docs/environment-variable-configuration-guide))。
您可以参考 [文本生成](/docs/text-generation) 的模型代码示例,通过对`model`字段赋值 Endpoint ID 的方式来发起调用。平台会返回执行该请求的实际模型和响应信息。
```Bash
curl https://ark.cn-beijing.volces.com/api/v3/chat/completions \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $ARK_API_KEY" \
-d '{
"model": "ep-2xxxxxxx1-rr9kp",
"messages": [
{"role": "system","content": "你是人工智能助手."},
{"role": "user","content": "你好"}
]
}'
```
## 步骤三:观测智能路由效果
单击接入点名称进入当前接入点的 **概览** 页面,您可在 **智能路由效果监控** 区域观测智能路由的效果,了解总计使用次数、总计节约成本、不同模型的使用比例等关键指标,从而评估智能路由策略的有效性和经济性。
